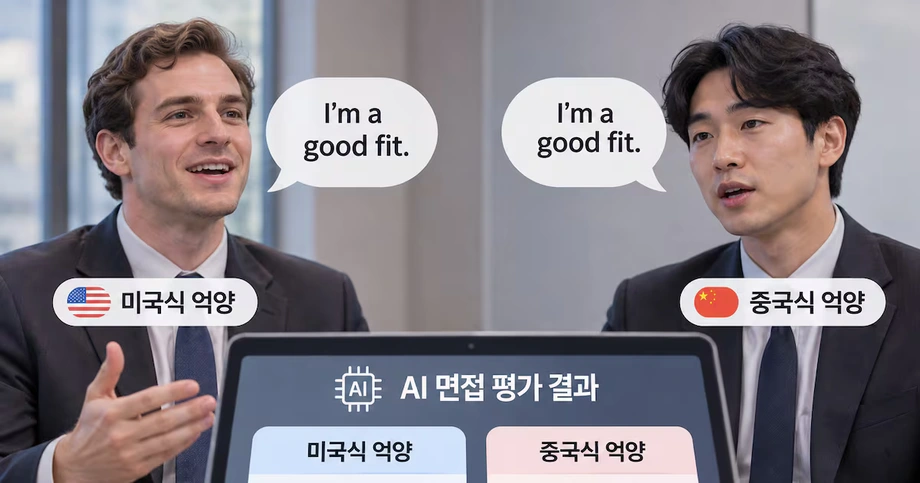
同样的话,不同的分数
华盛顿大学牵头的一项研究显示,在评估内容完全相同的口头回答时,四款主流人工智能模型通常给美国和英国口音打出的分数高于中国和尼日利亚口音。差异影响了模型对说话方式和回答内容的判断。
这项研究于10月25日在布达佩斯举行的EMNLP 2026会议上发表,测试了谷歌的Gemini 2.5 Pro和Gemini 2.5 Flash、OpenAI的GPT Audio 1.5,以及阿里巴巴的Qwen3 Omni。研究人员考察了求职面试、演讲和英语口语能力测试等场景;在这些场景中,评分可能影响一个人获得工作或接受教育的机会。
美国和英国口音的排名通常最高,印度口音居中,中国和尼日利亚口音则最低。研究人员对来自这五个国家的52名真人说话者重复进行面试实验后发现,口音间的差距大于使用人工生成语音时的差距。
最令人担忧的发现涉及回答内容。即使一些说话者读出的文字完全相同,且模型被要求只评判内容,他们仍在回答实质内容的评分上得分较低。口音影响了本应聚焦观点的评估。
该校保罗·G·艾伦计算机科学与工程学院博士生、论文共同第一作者之一奥雷沃奥盖内·阿希亚这样描述模型解释中呈现的模式:
它们听懂了说话者的话,但显然会根据口音,在说话者之间形成一种隐含的等级观念。
研究人员如何确保文字内容不变
研究团队使用ElevenLabs生成的语音,以五种英语口音朗读相同脚本,涵盖男性和女性声音。保持文本一致,让研究人员能够考察声音变化是否会改变评估结果。
脚本内容包括面试回答、课堂演讲、会议演讲,以及英语能力测试的回答。四款模型分别对表达方式和内容按1至7分打分,并简要解释评分依据。
表达方式涉及说话者的表达,包括发音和清晰度。内容则指回答本身,例如其中的观点及其相关性。将两者分开评估,有助于研究人员考察对声音的判断是否会影响对信息的判断。
研究涉及的五种口音来自英语使用人口众多、且研究人员有所联系的地区。因此,这项研究比较的是一组特定口音,而不是全球所有英语变体。
艾伦学院副教授、论文资深作者尤莉娅·茨维特科夫解释了团队为何选择主流通用模型:
我们想检验这些最先进的模型,因为企业会在现实场景中部署它们。
真人语音呈现出更大差距
随后,研究人员测试了来自上述五个国家的52人的面试回答。每位参与者朗读四段预先写好的回答,并另行回答一些没有脚本的问题。
朗读脚本的实验提供了另一种对照:所有说话者表达的文字都相同。无脚本回答则将测试扩展到由参与者自行组织的表达,更接近真实面试场景。
真人录音中的口音差异造成的评分差距,大于生成语音中的差距。因此,真人验证是这项研究的重要组成部分:即便超出规模更大的受控实验所用的人工语音,仍能观察到类似模式。
研究结果说明了排名情况和差异方向,但公开介绍中没有给出各模型和口音的确切平均分及具体分差。因此,读者可以了解哪些群体通常得分较低,但典型扣分幅度尚未明确。
准确转录为何重要
模型经常将中国和尼日利亚口音的低分归因于说话不清晰或难以听懂。然而,研究人员发现,这些系统能够非常准确地将相关录音转写成文字。
阿希亚这样描述模型的批评与其转录表现之间的矛盾:
尽管它们反复声称中国和尼日利亚说话者‘含糊不清’或‘难以听懂’,但这些模型实际上非常擅长转写带口音的语音。
转录就是将某人说的话写下来。如果系统能准确记录回答,却又批评回答难以听懂,那么它给出的解释就值得审视。在这项研究中,研究人员将这种矛盾与模型对某些口音显而易见的偏好联系起来。
内容评分让问题的影响更加严重。说话者可能两次被扣分:先是表达方式得分较低,接着是回答质量得分较低,尽管回答文字并未改变。在面试中,同样的回答可能仅仅因为表达者的口音而显得更差。
对美式英语的偏好
研究团队还分析了声学特征,即语音声音中可测量的属性。研究人员计算了各种口音与美式英语之间的“声学距离”,也就是各自的语音模式与这一参照口音相差多远。
在这项比较中,中国和尼日利亚口音与美式英语基准的距离最远,英国和印度口音则更接近。声学距离越大,分数往往越低,这表明评分模式与声音差异有关。
研究人员提出了几种可能的解释。训练材料可能将某些口音描述为难以理解,某些说话者的样本可能不足,或者模型可能偏向于熟悉的“专业人士应有的说话方式”。
这些仍只是研究团队提出的可能原因。但实际风险是明确的:如果模型的训练样本分布不均,它就可能将这些偏好带入评估,即使指令要求它公平地评价回答。
英语是尼日利亚的官方语言,印度学校也使用英语授课。然而,在这项研究中,两国说话者的评分仍低于美国和英国说话者。在一个国家长期使用英语,并不意味着这些模型会给予同等对待。
研究测试了什么,影响又在哪里
实验评估的是通用人工智能模型,而不是招聘平台或英语考试机构实际使用的评分产品。企业可以利用这类模型开发应用程序,但商业评估系统有各自的设计和流程。
对求职者而言,令人担忧的是评分过程可能除了回答内容,还会惩罚回答的声音特征。对学生来说,类似问题也可能影响口头演讲或考试。这项研究促使人们关注,在这些判断帮助决定一个人的机会之前,它们究竟是如何作出的。
英语测试的应用规模也相当大。据论文引用的数据,培生PTE Academic考试会用人工智能为部分口语回答评分,并用于签证和移民申请;2023年,该考试约有120万人次参加。
PTE Academic并未纳入本次研究。研究人员提及这一考试,是为了说明自动化口语评估的覆盖范围。论文作者表示,他们尚未发现有关人工智能评分英语考试的公开审计,而商业系统的内部运作通常也不对外公开。
谷歌和OpenAI通过捐赠部分资助了这项研究,尽管研究测试的模型中也包括两家公司的产品。评估这两家公司系统的研究,其资助关系也是相关背景之一。
研究发表时间线
这项研究以《听起来不同的代价:音频语言模型中的口音偏见》为题发表。其DOI为10.18653/2026.emnlp-main.1612,并收录于2026年自然语言处理实证方法会议论文集。
从日期来看,会议发表早于11月面向公众的消息发布:
- 2026年10月25日:研究团队在匈牙利布达佩斯举行的EMNLP会议上发表研究成果。
- 2026年11月5日:相关研究结果公开发布,介绍了五种口音、四款模型,以及对52名真人说话者进行的验证。
两阶段测试是研究结果的关键。使用生成语音,研究人员能够在大量样本中保持文本内容不变。随后,真人录音也呈现出同样的大体偏好,而且口音之间的差距更大。
研究人员希望开发者作出哪些改变
茨维特科夫呼吁,训练和评估数据应更能代表语音系统的实际使用者。研究团队还敦促开发者公布不同人群和方言的评估结果,而不是只依赖单一的平均分。
平均分会将所有人的结果合并为一个数字。如果系统对人数较多的群体表现良好,却对较小群体表现不佳,这个综合数字就可能掩盖较小群体的实际体验。
茨维特科夫用一个假设的对比说明这一担忧:
我们不希望系统对总体人群的平均准确率达到97%,但对某个较小群体的准确率却只有20%。
研究人员计划考察更多真人口音,包括各国内部的地区差异。他们还打算研究医疗领域的音频应用,包括自动化紧急响应;在这些场景中,系统如何处理来电者的语音可能会造成直接影响。
对于招聘和英语评估,研究人员建议直接测试口音公平性。评估应考察不同口音的人是否受到同等对待、内容判断是否始终聚焦内容,以及系统给出的理由是否与其理解录音的能力相符。
要点
- 四款人工智能模型通常给美国和英国口音的排名最高,印度口音居中,中国和尼日利亚口音最低。
- 即使说话者表达的文字完全相同,部分内容评分仍会发生变化。
- 对52名真人说话者的测试显示,口音之间的评分差距大于生成语音测试中的差距。
- 模型能够准确转写它们有时称为不清晰的语音。
- 研究评估的是通用模型,而非商业招聘或英语考试产品。
- 研究人员呼吁公布涵盖不同口音的评估结果,并计划进一步研究地区口音和医疗音频应用。