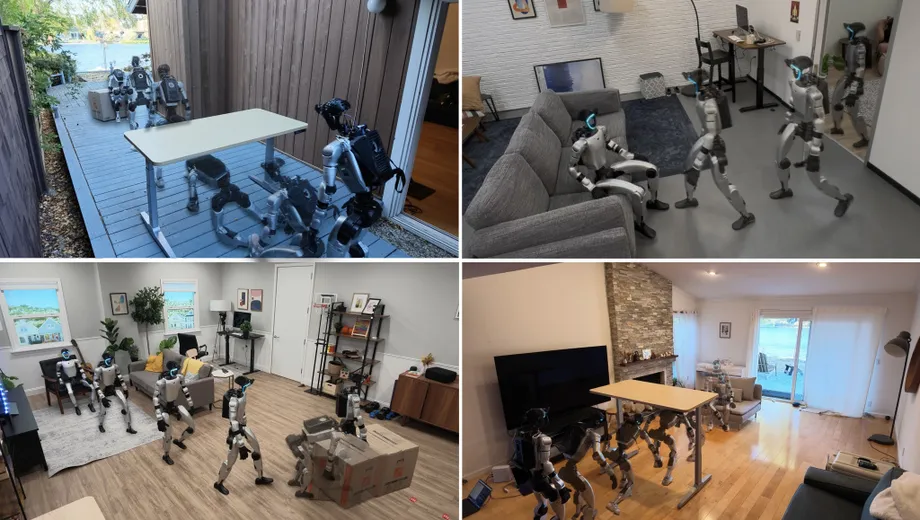
在虚拟家居中训练的机器人走进真实房间
苹果研究人员表示,其HALO人形机器人控制系统在六个从未为其扫描或测绘的真实环境中进行了360次试验,单项实体任务的平均成功率为91%。该系统搭载于宇树科技G1机器人,利用模拟训练中学到的经验,在陌生空间中导航、坐上家具、穿过狭窄开口并推动箱子。
目录
研究成果见于《从模拟到感知人形运动》,该论文于2026年11月4日提交至arXiv。苹果团队的论文介绍了系统的训练过程:在1,000个计算机生成的家居环境中,使用约300小时的合成示例进行训练,随后将系统直接迁移到实体机器人上。
较长的任务更难完成。在另一个真实环境中,HALO尝试了三种动作组合,每种尝试10次,平均成功率为70%。在要求机器人钻过障碍物、接近目标并推动箱子的动作序列中,10次尝试成功了5次。
这项工作的实际进展,在于将理解指令与让整个身体穿行于陌生家具环境结合起来。比如,坐到椅子上的指令要求机器人识别座位、找到路线、调整身体位置,并在坐下时保持平衡。HALO由三个相互配合的控制层分担这些任务。
作者为Siyuan Hu、Abulikemu Abuduweili、Yue Meng、Shipeng Liu、Quentin Leboutet、Chen Chen、Matthias Müller和Vladlen Koltun,论文均标注其供职于苹果。他们还发布了涵盖数据生成、训练和部署的代码,包括在模拟环境和实体机器人上进行任务规划、运动生成和运动跟踪的代码。
91%的结果涵盖哪些任务
六项单独技能的成功率各不相同。下蹲表现最好,坐下则是受测动作中成功率最低的一项:
- 前往指定物体:92%。
- 坐上家具:85%。
- 穿过半开的门:93%。
- 从障碍物下方蹲行通过:100%。
- 从障碍物下方爬行通过:90%。
- 推动箱子:88%。
下蹲和坐下的成功率相差15个百分点。坐下不仅要到达正确位置:机器人还必须与家具对齐,并将身体重量转移到座位上。这既考验其视觉理解能力,也对实体控制器提出要求。
HALO对六个评估环境都不熟悉。研究人员事先没有对这些环境进行扫描,也没有在训练中使用过它们。论文将此称为零样本迁移,即系统从模拟训练直接迁移到这些实体环境,无须针对每个新环境进行额外训练。
演示视频还展示了G1跟随一个人、坐在沙发上、侧身穿过半开的门,以及从桌子下方弯腰或爬行通过。这些动作表明,系统会根据周围空间调整姿态,而不是只朝目的地行走。
为什么较长的指令更难
HALO在三种组合任务中的成绩差距更大。先穿过门再前往目标的任务,10次尝试全部成功。先下蹲再坐下的任务成功了6次。先下蹲、接近目标再推动箱子的任务成功了5次。
这三项任务合计30次尝试中成功21次,成功率为70%。这比单项任务的平均成功率低21个百分点,不过组合任务测试使用了不同的环境,试验次数也更少。
动作序列会带来更多出错机会,因为前一个动作的结果会成为下一个动作的起始状态。例如,从障碍物下方出来后,机器人必须仍能接近目标并完成下一步动作。
HALO通过视觉检查来应对这一问题。其规划器会查看机器人视角的视频,判断当前动作是否成功,并决定是继续执行还是重试。结果表明,将有效技能串联起来,比单独完成这些技能更具挑战性。
三个控制层将指令转化为动作
最高层负责任务规划。它使用视觉语言模型(一种同时处理图像和文字的人工智能)结合摄像头画面来解读指令。默认模型为Qwen3.6-35B-A3B,在机器人携带的Mac mini上本地运行。
规划器每两秒调用一次。如果有人让机器人坐下,却没有指定座位,机器人就必须从视野中的物体里选出合适的目标。如果桌子挡住了通往椅子的路线,它可以把指令拆分成更小的动作:从障碍物下方钻过、接近椅子,然后坐下。
中间层将每个子任务转化为运动计划。它结合了Qwen3.5-2B(训练期间其编码器参数保持固定)和一个用于生成全身动作的扩散变换器解码器。编码器将图像和指令转化为运动模型可用的表示,解码器则生成计划姿态。
这一层会向前规划约五秒,并以每秒约三次的频率重新规划。因此,它会根据摄像头的新观测持续更新预定动作,而不是一次性确定五秒的动作后便不再查看周围环境。
最低层称为运动跟踪器,每秒50次将计划转化为关节指令。它结合深度图像以及机器人自身位置和动作的信息,帮助机器人在遵循计划的同时兼顾平衡、接触情况和电机限制。
Mac mini搭载在G1上
实体系统将一台搭载M4 Pro芯片、配有64 GB统一内存的Mac mini装入防护外壳,安装在G1背部。这台电脑运行计算量更大的任务规划和运动生成模型。G1自身的机载处理器则运行运动跟踪器。
定制头部支架上装有一台OAK-1W摄像头。它的彩色视频流分辨率为1280×800像素,帧率为每秒30帧,视场角为120度。广角视野有助于系统在机器人移动时观察附近的家具和通道。
机器人无需连接线缆即可运行,其软件组件通过ZeroMQ(一种消息传递系统)通信。默认的本地配置无需互联网连接即可运行。HALO也可以在完成配置后通过应用程序编程接口调用云端模型。
计算任务的分工与控制层级相对应。理解指令可以低频进行,而保持移动中的机器人稳定则需要快得多的更新。运动生成器在计算新计划时,跟踪器会继续执行当前计划,避免每次模型需要计算时机器人都停下来。
1,000个虚拟家居如何提供训练示例
HALO的训练流程针对一个特定的短缺问题:将人形机器人看到的内容、接到的指令与全身应当如何运动联系起来的示例不足。普通视频包含动作画面,但训练这个系统需要将这些画面与指令及详细的机器人动作配对。
作者介绍了通过人工操作或可穿戴记录设备收集演示数据所需的时间:
由于每个片段都必须由人手动演示,收集一小时的数据至少需要一小时的人力。
HALO则通过模拟环境生成配对示例。首先,将一个任务拆分为多个动作片段。比如,坐进扶手椅可能包括向前走、转身和坐下。文本提示、路径航点和关键姿态为一个名为Kimodo的运动生成模型提供引导。
随后,自动几何检查会对候选动作进行评分,排查脚底滑动、身体穿透地板、突然跳跃以及关节超出活动范围等问题。流程会保留评分最高的候选动作,再将其放入虚拟房间中。
程序化场景生成器Infinigen提供了1,000种布局各异、家具不同的环境,包括客厅、办公室和卧室。系统会搜索合适的场景布置,确保机器人计划执行的动作和目标物体不会与周围家具发生碰撞。
随后,模拟器会使用与实体设备相匹配的模拟鱼眼摄像头,渲染机器人执行动作时能够看到的画面。对光照、曝光、颜色、对比度、模糊效果和传感器噪声进行调整,可以让图像更加多样化。每个生成的示例都将一条指令、一幅摄像头画面和相应的身体动作联系起来。
计算开销与人工投入
生成主要训练语料耗时约48小时,使用了250块英伟达H100图形处理器。这类处理器通常称为GPU,能够并行执行大量计算,从而一次性生成大量模拟数据。
动作生成器使用64块英伟达B200 GPU通过模仿学习进行训练。模仿学习是让模型学习复现示例行为的方法。运动跟踪器的训练使用了4块H100 GPU,结合了强化学习与策略蒸馏。
强化学习通过反复尝试和效果反馈来训练控制器。策略蒸馏则将学到的行为迁移到另一个模型中。在HALO中,这些方法帮助跟踪器把计划姿态转化为实体机器人能够执行的动作。
流程中仍有一些环节需要人工参与。添加新的实体任务需要编写提示词并设计关键姿态,有些动作还会参考人类视频或动作捕捉素材。一旦任务描述和约束条件确定,流程就能在许多生成的房间中重复使用。
因此,变化在于演示数据的扩充方式。HALO无需让人逐一完成每个片段,而是利用计算资源生成并检查任务的多种变体。
视觉仍无法解决接触问题
研究人员表示,HALO目前主要依靠视觉,无法直接感知接触。当任务涉及大量实体接触,且物体移出摄像头视野或被其他物体遮挡时,系统表现可能会下降。
推动箱子就说明了这一点。机器人需要在箱子移动时,始终保持身体相对于箱子的正确位置。摄像头可以提供可见位置的信息,而触觉传感器则能在视野受阻时提供仍然有用的接触信息。
研究人员指出,触觉感知是未来研究的一个可能方向,但没有给出添加相关功能的时间表。目前的结果明确显示了挑战所在:HALO能够在陌生房间里完成多项视觉引导的技能,但较长的动作序列和涉及接触的互动仍不够可靠。
这项研究带来的变化
苹果的这项研究将训练数据生成、语言驱动的规划和实体控制整合进同一个系统,让它能在人形机器人上运行,并应对从未到过的房间。最突出的成果是:系统从1,000个模拟环境迁移到360次实体试验中,且无需事先测绘六个测试地点。
公开发布的代码为模拟环境和硬件上的后续研究提供了这套流程。其范围既包括生成训练示例的工具,也包括生成、跟踪和协调动作所需的模型与软件。
对于让机器人坐下或搬动箱子的指令,可靠性取决于整个流程能否协同完成:识别正确物体、抵达物体、与其接触并完成动作。HALO的单项任务结果显示,这一流程已取得进展;组合任务的结果则指出,要让多个动作以同样的稳定性连贯完成,还有更多工作要做。
要点
- 苹果研究人员于2026年11月4日将《从模拟到感知人形运动》提交至arXiv。
- HALO在六个陌生且未经测绘的真实环境中进行了360次单项任务试验,平均成功率为91%。
- 在另一个真实环境中,三种组合任务共进行了30次试验,平均成功率为70%。
- 该系统结合了任务规划、运动生成,以及每秒发出50次关节指令的跟踪器。
- 训练使用了约300小时的合成示例,环境由系统生成,共有1,000个。
- 宇树G1搭载的Mac mini可支持无需互联网连接的本地运行。
- 训练仍需人工设计任务,接触感知能力有限仍是系统的弱点。