三款印度人工智能模型瞄准本地语言和私有化计算
印度在 IndiaAI Mission 计划下发布了三款自主研发的人工智能模型:Soket Labs 的 EKA-1,以及 ZenteiQ 的 Dhir 2B 和 Dhir 5B。这项于 2026 年 11 月公布的成果,汇集了印度人工智能计划的两项重点:支持印度语言的软件,以及无需持续联网即可执行实用任务的工具。
目录
EKA-1 拥有 263 亿个参数,支持英语和印度宪法第八附表所列的全部 22 种语言。规模较小的 Dhir 模型分别拥有 20 亿和 50 亿个参数,支持英语和 10 种印度语言。开发者介绍的应用场景包括回答有关文档的问题,以及辅助数学、编程和机构日常工作。
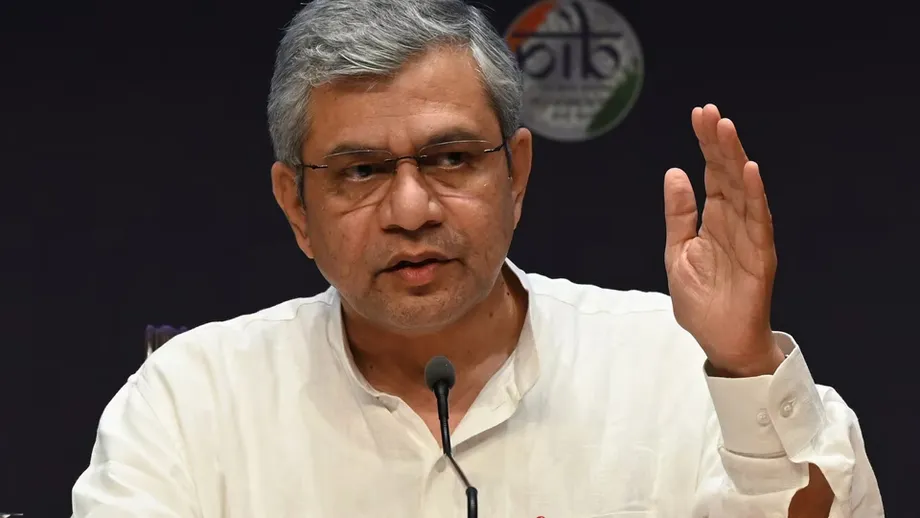
电子和信息技术部秘书 S. Krishnan 与该部及 IndiaAI 官员一同出席发布会。他表示,印度自主研发的模型有助于增强该国的技术自主性,并支持政府、工业、研究、教育和网络安全领域的工作。
最直接的实际意义,是用户可以有更多选择,决定人工智能在哪里运行。机构可以在自己的计算机上使用模型,部分移动应用也可以直接在手机上处理请求。对于需要处理敏感文件的机构而言,这提供了一种使用人工智能、同时将信息保留在自身计算环境中的方式。
研究人员、学生、初创企业、公司和公众可通过 AIKosh 使用这些模型。ZenteiQ 还计划推出一款免费移动应用。因此,此次发布既涵盖开发者可据此构建应用的基础模型,也包括一条面向普通用户的直接使用途径。
EKA-1 的设计用途
Soket Labs 开发 EKA-1,用于数学、编程和推理等任务。推理是指分析信息并据此得出答案。首席执行官 Abhishek Upparwal 表示,银行、金融服务和网络安全是重点关注领域;该模型的设计立足于印度数字经济的需求。
基础模型是一种经过广泛训练、能够支持多种应用的人工智能系统。开发者可以在其基础上构建更专业的工具,例如回答金融文件相关问题的服务,或帮助程序员编写代码的软件。EKA-1 的定位是提供底层能力,而不是只处理某一项范围狭窄的任务。
该模型的 263 亿个参数,是训练过程中经过调整的内部数值。这些数值帮助系统识别模式并生成回应。参数数量体现了模型的规模;用户还需要考虑语言质量、回答准确度、速度,以及执行特定任务所需的计算资源。
EKA-1 公布的训练数据量约为 7.5 万亿个词元。词元是文本处理时拆分出的片段,有时是完整的单词,有时只是单词的一部分。另一项公布的数据则称训练量为 75 lakh crore 个词元,相当于 75 万亿个。这意味着公布的训练数据总量存在明显差异。
印度语言支持有两种不同范围
EKA-1 支持英语和印度宪法第八附表所列的全部 22 种语言,这是其面向印度本土应用的核心特点。更广泛的介绍还称,该模型支持 100 多种印度及外国语言,以及编程语言。22 种这一数字指明了其所称支持的印度语言范围;更大的数字则涵盖更广泛的语言类型。
据介绍,Dhir 2B 和 Dhir 5B 支持英语和 10 种印度语言。与 EKA-1 相比,它们规模较小,所称支持的语言范围也更窄,可供机构根据所处理的文件、语言和设备作出不同选择。
对学生或公务人员而言,语言支持可能决定一款人工智能工具在日常工作中是否实用。如果文档助手能接受办公室或课堂使用的语言,用户在提问前就不必先把问题翻译成英语。不过,发布介绍没有提供各语言的性能结果,也未公布这三款模型可相互比较的准确率数据。
Dhir 模型为何更小
ZenteiQ 首席执行官 Sashikumaar Ganesan 教授将 Dhir 2B 和 Dhir 5B 称为紧凑型模型,并在发布会上解释了它们的规模:
我们发布了两款小型模型。我们称之为紧凑型模型……我们发布的是一款 20 亿参数模型,以及一款 50 亿参数模型……
EKA-1 的参数量约为 Dhir 5B 的 5.3 倍,约为 Dhir 2B 的 13.2 倍。这些比较依据公布的 263 亿、50 亿和 20 亿参数量得出。较小的模型通常需要较少内存来存储参数,因此有望在资源更有限的设备上运行。
ZenteiQ 表示,其模型可以直接在移动设备及不同计算平台上运行。Ganesan 这样描述预期的使用体验:用户无需将每次请求发送到远程服务,即可获得人工智能服务:
我们可以直接在自己的移动设备上运行这些模型……用户无需上云,就能在手边获得人工智能解决方案,这是第一点……
Dhir 模型旨在从文档中检索信息、回答问题并辅助日常工作。国防机构、政府部门、工业企业和教育机构都是潜在用户。
无需联网意味着什么
通过云端使用人工智能服务时,请求通常会发送到其他地方的计算机,由这些计算机处理后返回答案。在本地运行模型,则是将处理过程转移到手机或机构自己的设备上。安装所需软件和模型后,适合的任务即使没有实时互联网连接也能继续进行。
Krishnan 强调,这些模型有望在无法连接互联网的安全计算机网络中运行。这类网络与政府办公室及其他限制连接外部服务的敏感机构有关。例如,本地文档助手可以帮助员工搜索内部资料,同时让处理过程留在机构内部。
ZenteiQ 基于设备的方案,在网络连接较弱或时断时续的地方也可能派上用场。用户无需每次提出请求都依赖稳定连接。EKA-1 也被描述为能够在手机上执行部分任务,不过有关移动设备部署的主要宣传重点是较为紧凑的 Dhir 模型。
将信息留在设备上,能让设备所有者对数据处理地点拥有更多控制权。机构仍须管理文件访问权限、保护设备安全,并决定应用可以使用哪些文档。因此,隐私保护不仅取决于模型能否在本地运行,也取决于整个应用的部署方式。
云计算助力打造面向本地运行的模型
Dhir 模型在开发过程中使用了 Google Cloud 张量处理单元(TPU)的算力。这类专用处理器用于执行人工智能所需的大量计算。据介绍,这些模型也能在采用图形处理器(GPU)的系统上运行。
训练和日常使用是两个不同阶段。训练过程中,模型通过处理大量材料来调整内部数值。运行已完成的模型来回答问题,则称为推理。开发者可以在训练期间使用强大的云端设备,之后再分发模型,让它在本地硬件上执行推理。
IndiaAI Mission 为两家开发商提供了优惠计算资源,并协助承担研究费用。这些支持应对了开发基础模型的一项主要实际成本:获得足够的计算能力来训练和开发模型。
Krishnan 将这项计划与技术自主和战略自主联系起来。落实到实际层面,印度本土研发让当地机构多了一种模型来源;这些模型围绕本地语言和机构需求打造,也可部署在由机构自行掌控的基础设施上。
如何使用这些模型
AIKosh 是此次公布的访问平台,面向研究人员、学生、初创企业、商业机构和个人用户。对开发者而言,使用基础模型意味着可以围绕特定文档或任务开发应用。机构接下来需要选择适合自身设备、语言和信息管理规定的部署方式。
ZenteiQ 计划通过 Play Store 和 iOS 免费提供其移动应用。Ganesan 还表示,公司计划推出一款拥有 90 亿个参数的模型,扩充 Dhir 2B 和 Dhir 5B 之外的产品阵容。
此次公告没有给出移动应用或计划中的 90 亿参数模型的发布日期,也未说明支持的手机配置、内存要求、下载文件大小和模型许可条款。对于考虑能否安装软件或基于软件开发的用户来说,这些信息十分重要。
据介绍,发布会于周二举行;2026 年 11 月 3 日正是周二,但公告也将 11 月 4 日列为发布日期。这两种说法都将三款模型的发布置于同一周内。
对机构和用户有何影响
政府部门和企业现在又多了三款可用于语言和文档任务的印度本土模型。它们的规模各不相同:EKA-1 参数量更大,所称支持的语言范围更广;Dhir 模型则着重于紧凑运行,包括在移动设备上使用。
银行和网络安全是 Soket Labs 明确瞄准的领域。Dhir 的主要用途则包括文档检索和查询内部信息。学校、研究人员和公共机构也可以围绕这些能力构建应用,并选择适合自身工作的模型和计算环境。
接下来的具体进展包括通过 AIKosh 扩大使用范围、推出计划中的免费移动应用,以及 ZenteiQ 开发更大规模的模型。对用户而言,这些系统的实际价值取决于它们处理用户自身语言、文档和设备的能力。
要点
- 印度于 2026 年 11 月在 IndiaAI Mission 计划下发布了 EKA-1、Dhir 2B 和 Dhir 5B。
- EKA-1 拥有 263 亿个参数,支持英语和印度宪法第八附表所列的全部 22 种语言。
- Dhir 2B 和 Dhir 5B 支持英语和 10 种印度语言,专为紧凑部署而设计,包括在移动设备上运行。
- 本地处理有望支持网络访问受限机构的文档工作,也适用于网络连接有限的地区。
- IndiaAI Mission 为开发者提供了计算资源,并协助承担研究费用。
- AIKosh 是此次公布的访问平台;ZenteiQ 计划推出免费移动应用和一款拥有 90 亿个参数的模型。