可运行的GPU与5%的吞吐量优势
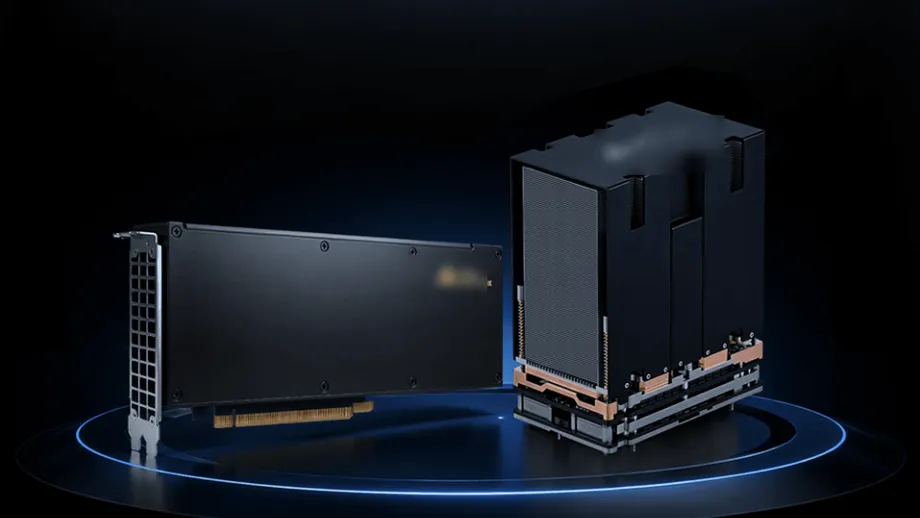
砺算科技在上海公开展示了天垓300图形处理器,并将其定位为英伟达H200的中国替代产品。公司称,在一项第三方推理测试中,天垓300的性能高出5%。在2026年10月28日举行的媒体开放日上,公司还展示了一套八卡训练系统,并介绍了一款搭载144块GPU和18颗CPU的机架。
目录
据砺算科技介绍,这项备受关注的对比来自上海电气集团于7月完成的测试。在一项将大语言模型处理分为两个阶段的部署方案中,天垓300的端到端吞吐量折算到单卡后,相当于H200的1.05倍。
吞吐量是指系统在一定时间内完成多少有效工作。对于聊天机器人而言,可以理解为每秒生成多少段文本。测试条件下,结果达到基准性能的1.05倍,意味着输出量多5%。
公司称,天垓300是首款在实测中达到H200性能水平的中国通用GPU。在10月的演示中,公司将对比范围扩展到语言模型、图像生成和视频生成;另一场训练演示则以英伟达H100为参照。
此次活动展示的不只是芯片规格。砺算科技还介绍了显卡、服务器、高密度机架设计、软件工具,以及在不同类型处理器之间分配AI任务的方法。公司的商业主张是,这些组件能够以更低成本、更短等待时间产出实用的AI结果。
与H200对比的测试指标
上海电气集团7月的测试采用了预填充与解码分离方案,通常简称PD分离。预填充是语言模型读取用户请求及相关材料的阶段;解码则是模型逐个生成词元、输出答案的阶段。词元是AI系统将文本划分成的小片段。
将两个阶段分开后,系统可以针对读取和生成任务采用不同的资源配置。因此,天垓300的测试结果针对的是一种特定部署方案,并将整体性能折算为单卡等效数值。
砺算科技尚未公布这项备受关注的第三方测试的详细方法、模型清单或工作负载条件。要独立复现测试,需要这些信息以及折算方式和软件设置。成本对比也没有公开明细,单卡显存和整机架的显存数据同样有待说明。
性能实验室公布的演示细节,让公司所称的性能表现更加具体。不同任务的提升幅度各异,从多模态生成的小幅提升,到推荐吞吐量的较大增幅。对采购方来说,真正相关的对比取决于其服务实际运行的任务。
长文档处理与更快的首次响应
据公司实验室数据,天垓300在上下文长度为64K时,注意力性能达到H200的1.05倍。注意力机制帮助模型判断输入中的哪些部分彼此相关。上下文长度为64K,意味着模型处理约64,000个词元。
在相同上下文规模下运行GLM-5.3时,砺算科技称,天垓300的吞吐量达到H200的1.15倍,同时保持相当的用户体验。这意味着在测试的混合专家工作负载中,性能提升15%。混合专家模型会将任务分配给选定的专用网络,而不是让每个词元都经过所有网络。
对于上下文长度介于8K至128K的AI智能体工作负载,公司称,首次输出词元的等待时间缩短约10%至30%。这项指标关系到用户在助手读完长文档或处理复杂请求后,需要等待多久才能看到它开始作答。
图像和视频生成也是演示的一部分。公司称,与H200相比,多模态生成吞吐量提升约2%至5%。在在线搜索、广告和推荐工作负载中,公司称推荐推理吞吐量提高21%,轻量级计算的延迟降低26%。
训练结果采用不同的英伟达参照产品
训练演示在一台八卡服务器上运行了Qwen3-32B模型,该模型约有320亿个参数。参数是模型在训练过程中调整、用于学习模式的数值。砺算科技称,单卡有效吞吐量达到英伟达H100的1.33倍。
因此,这场训练演示报告的性能优势为33%,对比芯片是H100。活动其他部分的推理结果则以H200为参照。理解这些数据时,必须将两种参照产品区分开来。
该训练系统以FP8精度运行。FP8使用8位存储数值,与使用更多位数的格式相比,可减少需要传输和处理的数据量。AI训练软件必须谨慎处理这种较低精度,以保持学习质量。
砺算科技还称,在满负载长时间运行期间,系统步时波动率为0.43%,而基于Hopper架构的参照系统为0.76%。步时是完成一个重复工作单元所需的时间。步时越稳定,运营方就越容易估算繁忙系统能够完成多少工作。
从7月发布到10月演示
天垓300于2026年7月在世界人工智能大会上正式发布。该芯片采用公司的天枢架构,集成新一代张量核心,规格为144GB图形内存。
该处理器支持标量、向量和张量运算。简单来说,它们分别处理单个数值、一组数值和更大型的数学数组。支持的数值格式包括FP4、FP8、FP16和BF16,软件开发者可据此在速度、内存占用和数值精度之间作出选择。
公司公布的关键节点跨越数月:
- 2026年7月:天垓300在世界人工智能大会上发布。
- 2026年7月:上海电气集团完成了被引用为H200吞吐量对比依据的第三方测试。
- 10月媒体活动之前:IXL144机架设计在中国国际工业博览会上亮相。
- 2026年10月28日:砺算科技在上海向媒体开放天垓300硬件的现场演示。
10月活动将产品展示从架构介绍推进到运行具体工作负载的系统。公司介绍的部署范围现已从单块加速卡扩展至八卡服务器和更大型的IXL144系统。
围绕144块GPU构建的机架
据砺算科技介绍,IXL144在一个标准机架中集成了144块GPU和18颗CPU,GPU总显存约为10.1TB。公司称,这是业内密度最高的单机架GPU超节点。超节点将多颗处理器紧密连接,使它们能够协同处理大型任务。
天垓300单卡标称144GB显存,而机架标称总显存为10.1TB,两项规格之间需要更清晰的配置说明。按144块卡、每块144GB计算,总容量为20,736GB,尚未考虑容量计量方式的差异。机架介绍需要明确说明卡的配置,以及工作负载实际可用的显存容量。
砺算科技估计,与主流国际系统相比,该系统每百万有效词元的成本可降低约40%。有效词元是指被计为有效工作的输出。对提供AI服务的运营方而言,这项指标将硬件开支与可用产出联系起来。
降低40%意味着,在参照系统完成成本为100个单位的工作时,成本将降至60个单位。实际节省金额取决于设备价格、功耗、软件、工作负载,以及GPU能否持续保持高利用率。
公司还为下一代点对点互连引擎提出目标:将连接域内单次传输时间从3至5微秒缩短到1微秒。不同GPU分别承载模型的不同部分、且需要反复交换数据时,更快的通信尤为重要。
在不同芯片之间分配AI任务
砺算科技的异构部署方案会将推理的不同部分分配给不同类型的处理器。根据其AFD分离方案,天垓300负责整个预填充阶段,以及解码过程中的注意力计算;合作伙伴的XPU则负责前馈专家网络。
XPU是对另一类计算加速器的统称。其基本思路是让每种处理器执行自己最擅长的工作,同时由统一调度器协调整个任务。前馈网络承担语言模型内部另一项主要的数学计算工作。
公司称,在统一调度下,解码推理延迟降低了60%。这是与H200吞吐量高出5%的结果不同的系统配置,采用的性能指标也不同。
砺算科技AI与加速计算负责人单天翼表示,未来的AI计算系统将取决于如何高效组织不同芯片,而不是让一种处理器承担所有任务。AFD演示展示了GPU与合作伙伴加速器协同工作的具体方案。
软件主打缩短部署时间
砺算科技还展示了一个旨在自动完成部分部署和优化工作的“AI for AI”软件栈。公司称,环境搭建时间从一小时缩短至10分钟,手动操作次数则从数十次减少到一次。
针对一项大型模型优化任务,公司称,工作周期从7天缩短至不到两小时,性能接近此前的两倍。这些案例涉及让模型在硬件上高效运行所需的工程工作。
公司还称,其与用于开发GPU计算程序的FlyDSL实现了深度集成。公司表示,编译速度提升了90%以上;此前需要10人耗时一天完成的工作流程,现在可由一人在数小时内完成。
处理器不只有强大的算术硬件,软件支持同样重要。模型、数学库和部署工具必须协同工作。软件演示所关注的是,客户要投入多少工程工作,才能将新GPU转化为可运行的服务。
TY1200将业务拓展至机器人领域
上海活动还展示了瞳扬TY1200。这是一款面向AI个人电脑和具身智能的独立处理器,应用对象包括能感知并在物理世界中行动的机器人。其标称稠密算力为300 TOPS,即每秒300万亿次运算。稠密算力指不依赖跳过涉及零值的计算来统计的运算能力。
砺算科技称,在涉及Qwen3.8-27B和Qwen3.6-35B-A3B的测试中,TY1200性能达到英伟达Thor T5000的1.2倍。对于物理AI场景中的Cosmos-R2-2B和Cosmos-R2-8B模型,公司报告的性能分别相当于Thor T5000参照值的158%和180%。
公司还称,TY1200可运行由GPU加速的MuJoCo-Warp物理仿真。这使机器人开发系统能够模拟运动、训练控制策略,并在本地检查动作。控制策略是机器人用来决定如何行动的一组学习所得指令。
据称,其应用包括协助患者就医的机器人、工业视觉和访客引导。正在规划中的后续产品TY2000,标称算力目标为600T。这些产品共同体现了公司的战略布局:从大型AI服务器延伸至靠近用户和机器运行的设备。
要点
- 砺算科技于2026年10月28日在上海演示了天垓300硬件。
- 公司引用上海电气集团的测试结果称,天垓300单卡吞吐量相当于英伟达H200的1.05倍。
- 一场使用FP8精度的八卡Qwen3-32B训练演示,据称实现了H100单卡吞吐量的1.33倍。
- 有关这项备受关注的第三方基准测试,详细方法尚未公布。
- IXL144机架配备144块GPU和18颗CPU,公司称其每百万有效词元成本降低40%。
- 另一种由GPU和XPU协同分担任务的部署方案,据称将解码延迟降低了60%。
- 活动还涉及软件自动化,以及TY1200在本地AI和机器人仿真中的应用。