一种学习 RNA 字母及其连接关系的模型
中国科学技术大学的研究人员发布了 structRFM,这是一种开放的 RNA 基础模型,使用 2100 万组 RNA 序列与计算注释结构配对数据进行训练。此次发布包括配对训练数据、模型权重和源代码,为其他实验室提供了复现研究并调整系统所需的材料。
目录
这项研究于 2026 年 11 月 4 日发表于 Nature,介绍了一种既能学习 RNA 分子构件排列顺序,也能学习帮助这些分子折叠的连接关系的模型。研究人员将其改造为三维结构预测模型,称为 Zfold。作者称,在 CASP15-natural、CASP16 和 RNA-Puzzles 评测中,Zfold 的表现可与 AlphaFold3 相媲美。
structRFM 的实际优势在于,训练完成后只需输入 RNA 序列即可。它生成的信息可用于多种任务,包括预测分子结构、识别参与 RNA 加工的位点,以及按功能对 RNA 分子进行分类。
Nature 上的structRFM 研究论文将这项工作定位为一种让结构知识适用于不同预测任务的方法。彭雄和 S. Kevin Zhou 为通讯作者,朱荷琴为第一作者。
折叠为何与序列同样重要
RNA 参与蛋白质生成、基因调控和遗传信息的加工。它的序列是核苷酸的排列顺序,这些分子单元通常用字母 A、U、C 和 G 表示。排列顺序承载着信息,而分子的折叠方式则有助于决定其功能。
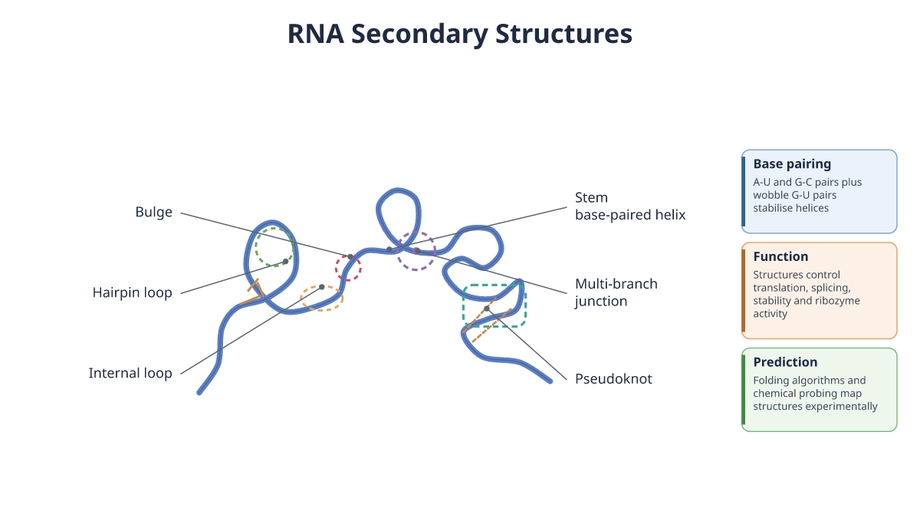
RNA 链的某些部分可以与同一条链的其他部分配对。这些连接会形成二级结构,即由配对区域、茎和环构成的模式。随后,分子会折叠成三维形状,即三级结构,这会影响其活性以及与其他分子的相互作用。
许多 RNA 语言模型从大量序列集合中学习模式,其方式类似于语言模型学习词语之间的关系。structRFM 在训练中加入了哪些核苷酸彼此配对的信息,帮助模型学习序列中相距较远位置之间的连接关系。
研究人员希望保留基础模型的灵活性:这是一种经过广泛训练、其学习到的特征可针对不同用途进行调整的系统。他们的目标是将折叠信息纳入这一通用基础,而不是训练一个只适用于单一结构任务的系统。
如何组建 2100 万组训练配对数据
研究团队构建了一个包含约 2100 万组 RNA 序列与二级结构配对数据集。结构注释通过计算生成,使研究人员能够以远超仅由实验解析结构组成的数据集的规模进行训练。
计算机预测可能存在错误,也可能反映生成预测的方法本身的优势与局限。为减少对单一预测器的依赖,研究人员推出了 MUSES,即多来源二级结构集成方法。集成方法会综合多个预测来源的信息,而非完全依赖单一来源。
MUSES 旨在解决利用预测结构训练模型时的一个核心问题:训练注释中反复出现的错误可能影响模型学到的内容。整合多种结构预测结果,旨在减少预测器偏差,同时保留有关碱基配对的有用信息。
该研究的训练和评估资源借鉴了 RNAcentral、Rfam 和蛋白质数据库(Protein Data Bank)等成熟的生物学数据集。论文的数据声明列出了相关版本,包括 RNAcentral 24.0 版以及 Rfam 14.10 版和 15.0 版,以便研究人员追溯实验所用数据集。
通过隐藏信息训练模型
structRFM 使用掩码语言建模,这种训练方法会隐藏输入的一部分,并让模型根据上下文恢复缺失信息。对于 RNA 而言,这意味着学习核苷酸之间的关系,而不是词语之间的关系。
研究团队通过配对匹配操作,将碱基配对信息融入这一过程。动态掩码比例在由结构连接引导的训练与针对单个核苷酸位置的掩码之间取得平衡。这让模型有机会同时学习局部序列模式和与折叠相关的关系。
最终模型提供三类特征:关于整个序列的信息、关于每个核苷酸的信息,以及关于核苷酸对的信息。特征是另一种预测系统可以使用的数值表示。不同任务可以利用这种表示的不同层级。
研究人员还进行了消融实验,即移除或改变模型的部分内容,以检验它们的作用。这些实验支持结构信息和掩码策略均对所报告的改进有所贡献,为 structRFM 的设计选择提供了证据。
结构测试结果
structRFM 在零样本同源性分类中表现出色。同源性指由共同进化起源传承而来的关系。在这种测试中,零样本分类用于检验模型学到的表示能否识别此类关系,而无需针对目标分类任务进行专门训练。
作者还报告称,模型改进了二级结构预测,并在新发布的 RNA 家族上表现出色。RNA 家族是指具有共同序列或结构特征的相关分子群体。对新发布家族进行测试,可以考察模型在成熟数据集中已有的熟悉群体之外的表现。
对于三级结构预测,研究团队通过调整 structRFM 学到的特征,开发了用于预测三维形状的模型 Zfold。作者报告称,预测形状和从预测结果中提取的二级结构均有所改进。
Zfold 在 CASP15-natural、CASP16 和 RNA-Puzzles 上进行了评估,这些基准数据集用于评估分子结构预测。论文称,Zfold 在这些评测中的表现可与 AlphaFold3 相媲美。这一比较针对的是 Zfold 在上述基准测试中的结果,而 structRFM 则提供底层 RNA 表示。
这项研究展示了多方面的成果,而非一个涵盖所有用途的准确率分数。识别相关序列、预测碱基对和重建三维形状是不同的问题,各自需要单独评估。
从 RNA 加工到功能分类
研究人员还在关注 RNA 功能的任务上测试了 structRFM。这些任务包括剪接位点预测、内部核糖体进入位点识别和非编码 RNA 分类,使评估范围扩展到分子形状之外。
剪接位点标记了细胞加工 RNA 信息时使用的边界。剪接过程中,部分片段会被移除,其余片段则连接起来。预测这些边界有助于研究人员考察遗传信息在用于生成蛋白质之前如何组装。
内部核糖体进入位点(IRES)是 RNA 区域,能让负责生成蛋白质的细胞机制从内部启动翻译。识别 IRES 需要发现序列中的功能模式,因此也能检验预训练期间模型捕捉到的信息。
非编码 RNA 承担的功能并非充当蛋白质生成的模板。对其进行分类,意味着将分子归入相应类别。作者报告称,模型在这些功能任务上的表现均有所提升,表明当预测目标从结构转为生物学作用时,学到的表示仍然有用。
研究团队还采用分段策略,将模型扩展到长链非编码 RNA 分类。将长序列拆分成多个片段后,便可处理原本难以作为单个整体输入的序列。
开放发布为研究人员提供什么
此次发布涵盖三种用途各异的资源:数据集提供模型学习所用的样本;模型权重包含训练期间学到的数值;源代码则说明软件的实现和运行方式。
获取模型权重后,研究人员可以基于已训练好的模型开展工作,无需重做整个预训练流程。获取数据和代码则有助于深入审查训练过程、复现实验并开发替代方法。
论文列出的项目代码库位于 GitHub,名称为 heqin-zhu/structRFM。论文还列出了预训练数据集的 Zenodo 存档,DOI 为 10.5281/zenodo.18272040,以及源代码和模型检查点的存档,DOI 为 10.5281/zenodo.18274292。DOI 是一种持久标识符,旨在确保研究资源能够长期追踪。
数据声明称,训练集和测试集可通过项目代码库公开获取。声明还提供了研究中使用的经过处理的 IRES 数据划分,以及图表所依据的源数据。作者表示,数据获取不受任何限制。
这些细节对结果比较十分重要。研究人员可以检查所用的数据集和划分方式、重新运行评估,并测试不同的训练选择是否会改变结果。因此,此次发布既支持对研究发现进行审查,也有助于复用模型。
团队与发表时间
这项工作由中国科学技术大学生物医学工程学院以及医学成像、机器人、分析计算与学习实验室(简称 MIRACLE)牵头完成。作者列出的机构还包括位于合肥的单位和中国科学技术大学苏州高等研究院。共同作者李瑞峰隶属于杭州的浙江大学计算机科学与技术学院。
教授 Zhou 和特任研究员彭雄提出并监督了这项研究。朱荷琴负责设计和实现框架、开展预训练以及若干结构预测和 RNA 分类实验,并分析结果。其他团队成员负责同源性测试、数据集比较、IRES 识别和结构评估。
这项工作的发表和公开发布分别发生在两个日期:
- 2026 年 11 月 4 日:Nature 列出论文《一种面向泛化预测的开放结构引导型 RNA 基础模型》的发表日期。
- 2026 年 11 月 5 日:该研究及其开放发布在中国公开宣传,在线发表时间据称为清晨。
作者表示,这项研究获得了中国国家自然科学基金、国家重点研发计划、江苏省和苏州市科研项目以及深圳市医疗卫生三名工程项目的支持。他们声明不存在利益冲突。
研究结果对 RNA 研究的影响
structRFM 为多种研究工作提供了共同起点。研究 RNA 加工的实验室可以调整同一个底层模型,而其他团队则可用它研究折叠或对非编码分子进行分类。每种应用仍需针对具体任务进行开发和评估。
2100 万组训练配对数据、结构引导学习和公开发布的检查点相结合,为研究人员提供了可供检验的具体系统,而不只是算法描述。MUSES 和掩码实验也提供了具体的设计选择,其他团队可以对其进行测试或修改。
研究报告的结果集中于计算预测和分类。要推进生物医学应用,还需开展更多生物学实验,包括核验预测结构,以及测试特定 RNA 分子被赋予的功能。
论文没有给出临床应用的时间表。眼下最直接的变化是资源开放:全球研究人员都可以获取训练资源、检查模型实现,并探索所报告的性能提升是否适用于自己的 RNA 数据集。
要点
- 中国科学技术大学研究人员发布了 structRFM,这是一种使用约 2100 万组序列与二级结构配对数据训练的 RNA 基础模型。
- 模型学习序列模式和碱基配对关系,随后仅凭序列输入即可生成特征。
- MUSES 整合多个结构预测来源,动态掩码则在训练中平衡结构信息与核苷酸信息。
- 作者报告称,模型在同源性分类中表现出色,二级结构预测有所改进,并通过了对新发布 RNA 家族的测试。
- 用于三级结构预测的改进模型 Zfold 在三个指定基准数据集上的表现被描述为可与 AlphaFold3 相媲美。
- 数据集、模型权重、源代码和评估资源均已公开,可供复用和复现。