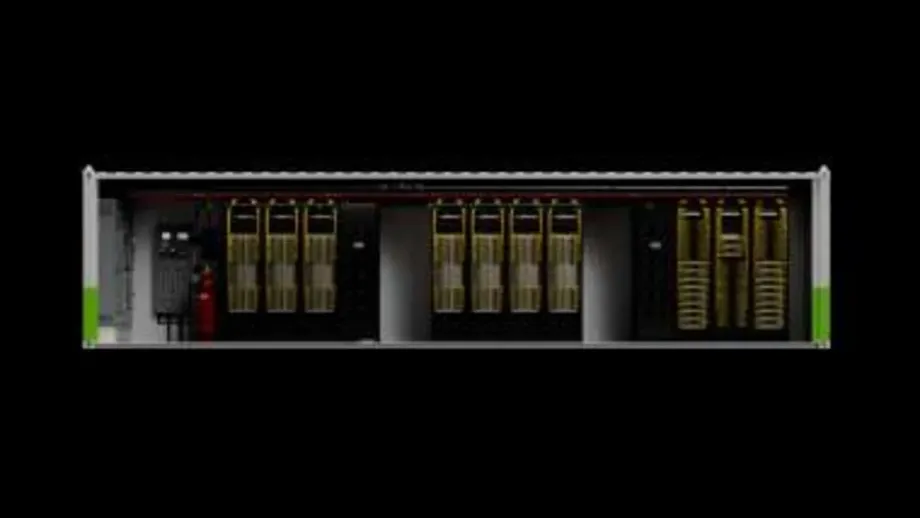
七个 AI 机架、一个集装箱,更快实现营收
英伟达推出 DSX POD 模块化 AI 工厂设计,将七个 Vera Rubin NVL72 计算机架装入集装箱,在发货前完成组装和测试。该公司表示,在场地准备就绪的情况下,部署最快可在 14 天内完成,而传统安装和集成通常需要约六个月。
目录
这项设计于 2026 年 10 月 21 日在 GTC 柏林大会上宣布,将六家台湾企业纳入全球交付网络:通过 Ingrasys 参与的鸿海、台达、技嘉、和硕、广达云达科技(QCT)和纬创。全球交付计划于 2027 年初启动。
这 14 天指的是目的地已备妥所需电力、冷却、网络及配套基础设施后的部署时间。场地准备、地基施工、电力接入及其他设施建设仍属于整体项目工期的一部分。
英伟达的商业逻辑很直接:如果在目的地需要组装的电缆、管道和系统更少,昂贵的处理器就能更早开始投入有效运算。AI 工厂是用于训练 AI 模型或为客户运行模型的数据中心。其产出包括 token,即模型处理和生成的少量文本或其他信息。
英伟达创始人兼首席执行官黄仁勋这样描述基础设施开始创造价值的时刻:
AI 工厂开始生成 token 时,就开始创造价值。
因此,对运营商来说,目标不只是完成建设,而是更具体的“首次生成 token 时间”:新设施开始为实际客户工作负载运行模型的时刻。只要客户已准备好使用算力,设施越早投入运营,公司就越早有机会销售计算服务。
DSX POD 内部装有什么?
一个计算集装箱的七个 NVL72 机架共搭载 504 个 Rubin 图形处理器(GPU)。GPU 可以同时执行大量计算,因此适用于 AI 涉及的庞大数学运算任务。将数百个 GPU 连接起来,就能分担单个处理器无法承担的工作。
集装箱重约 28,000 公斤,即 28 公吨,尺寸与标准集装箱相当。其集成系统包含约 1,000 万个组件和 3,500 条电缆。连接线路包括约 20 公里的 NVLink 铜缆,用于连接处理器;以及 17 公里的网络线路,用于整个计算系统内的通信。
英伟达的设计不止涵盖计算机架,还包括存储、服务和管理功能、电力分配、冷却、控制系统,以及集装箱之间的连接。存储系统必须足够快速地传输训练数据、模型信息和保存的进度,才能持续为处理器提供工作任务。
因此,这是一套参考设计,而不是由英伟达独自制造的单一成品。参考设计为合作伙伴提供共同的工程基础,包括布局、接口和测试要求,合作伙伴据此构建并支持客户安装项目。
工厂组装如何改变工期
传统安装需要目的地的团队安置机架、铺设电缆、连接冷却管道,并测试互联设备。这些工作需要不同专业人员按正确顺序到场,配备合适组件,同时还要等待建筑和公用设施准备就绪。
DSX POD 将许多可重复的工作转移到制造工厂完成。合作伙伴在发货前完成机架间连接、电气布线、冷却管路铺设和功能检查。与此同时,目的地团队可以准备地基、电力、外部冷却设施和网络接入。
因此,工厂作业与场地准备可以同步进行。交付后,工作人员安置集装箱,将其连接至相邻单元和外部设施,检查运输后的状态,并完成调试。调试是指验证连接完成的安装系统在工作条件下能否按预期运行。
英伟达副总裁、超大规模计算业务负责人 Ian Buck 将设备到场后的流程描述为安置、连接和最终测试。老化测试是最终流程的一部分,通过运行设备在正式投入服务前排查故障。英伟达预计,将集成工作转移至工厂,可以降低组件延迟和安装期间出现高成本错误的风险。
部署分为三个主要阶段:
- 2026 年 10 月 21 日:英伟达在 GTC 柏林大会上发布 DSX POD。
- 部署前:合作伙伴组装并验证集装箱,目的地团队则准备配套基础设施。
- 2027 年初:计划开始全球交付;在场地准备就绪的情况下,部署目标时间最快为 14 天。
台湾合作伙伴进一步拓展完整系统业务
鸿海旗下 Ingrasys 参与了 DSX POD 的早期设计和制造工作。该集团与业务涵盖计算系统、电力基础设施和制造集成的台湾企业并列参与此项目。QCT 隶属广达,台达、技嘉、和硕和纬创则是英伟达列出的其他台湾合作伙伴。
整个生态系统共有 17 家合作伙伴。除上述六家外,还有 Anduril、Armada、Bull、Crusoe、DayOne、戴尔科技、伊顿、HPE、联想、施耐德电气和维谛技术。名单涵盖计算设备制造商,以及从事电力、冷却、模块化基础设施和部署的企业。
英伟达提供经过验证的设计基础。设备制造商集成计算系统;基础设施专业企业调整电力和冷却配置;模块化基础设施供应商制造外壳并集成子系统;场地合作伙伴则负责场地准备、安装和调试支持。
Ingrasys 的参与也延续了鸿海与英伟达于 2025 年宣布的台湾超级计算中心计划。该项目计划投资 14 亿美元,供电能力为 27 兆瓦,目标是在 2026 年上半年开始运营。该中心由 Visonbay.ai 开发,基于 Blackwell GB300 系统,展现了鸿海拓展 AI 基础设施制造业务、并销售算力使用服务的布局。
DSX POD 将双方合作中的制造环节延伸至更大型的集成单元。更多组装、测试和运输工程在交付前完成,使工厂承担起更大比例的系统集成工作。
电力和冷却仍是每次部署的关键
英伟达的DSX POD 技术说明由产品管理高级总监 Premal Savla 于 10 月 21 日发布,其中规定了采用 800 伏直流电的标准输入设计,涵盖电气保护、配电、接地、机架连接、控制系统和遥测,即用于监测设备的测量数据。
合作伙伴必须根据各地情况设计上游电力供应和转换设备。不同地区的电气规范、可用设备和电网配置各不相同。集装箱接口处采用通用接口,可以保持核心设计可重复,同时根据当地条件定制外部供电系统。
液冷系统负责带走高密度计算机架产生的热量。工厂团队可以在发货前组装、冲洗并对内部管路进行压力测试,检查是否泄漏,并验证传感器。目的地团队随后将集装箱连接到已准备好的供水和排热基础设施,并验证完整的冷却回路。
英伟达还介绍了更广泛的 DSX 架构中的冷却方案:冷却水以 45 摄氏度进入系统,并通过干式冷却器构成闭环。闭环会反复循环冷却液;干式冷却器将热量传递给外部空气,而非依靠蒸发散热。
该公司估计,采用这一方案的合适设施,在 2 吉瓦规模下每天最多可节水 5,400 万升。这是针对超大规模部署的预测。实际用水量取决于冷却配置、当地气候以及作为比较基准的设施。
安装电力之外,还要管理电力
英伟达更广泛的 DSX 平台包括 MaxLPS,可动态地将电力分配给需要电力的计算任务。该公司表示,这项技术最多可在输出不变的情况下减少 30% 的用电量。相关软件还能帮助运营商按照设施可用电力安排工作负载。
DSX Flex 针对的是另一种限制:电网其他部分的用电需求。它采用应用程序编程接口(API),让数据中心系统能够与电力运营商自动协调。在用电高峰期间,一些计算任务可以延后或减少,以便将容量留给其他用户。
Buck 表示,协调方式正从可能依赖电话沟通转向自动化协调。对运营商而言,这意味着既要考虑最大供电能力,也要考虑工作负载的时间安排。可以暂停的训练任务,与必须即时响应的客户服务,对调度的要求并不相同。
黄仁勋在柏林将 AI 基础设施概括为五个相互连接的层次:电力、先进计算、AI 工厂、模型和应用。DSX POD 侧重于加快实体基础设施投入运营,而电力管理工具则着眼于提高已安装算力的运行效率。
延误数周意味着高昂代价
黄仁勋在 GTC 柏林大会上举了一个涉及巨额资金的例子:一座用电量为 1 吉瓦的 AI 工厂可能耗资约 500 亿美元,每年创造约 400 亿美元营收。按这一假设的营收水平计算,延误三个月将相当于损失约 100 亿美元营收。
黄仁勋在谈到这一估算时说:
100 亿美元的营收损失会让任何人都感到焦虑。
这一计算说明了英伟达为何重视让已安装的硬件尽快投入使用。相关营收假设针对的是达到所述规模并投入运营的虚拟设施。每个运营商的回报将取决于需求、利用率、价格和运营成本。
黄仁勋还表示,从设备到场、完成安装到开始生成 token,所需时间已从四五个月缩短至约一个月。DSX POD 发布时提出了更具体的目标:在准备就绪的场地,部署时间最快可缩短至 14 天;英伟达给出的传统部署对比时间为六个月。
英伟达还将 Vera Rubin 定位为 AI 智能体平台。AI 智能体是能够借助模型和工具执行任务的软件。黄仁勋表示,过去十年 AI 性能提升了 100 万倍,并称 Vera Rubin 相关处理性能在两年内可达到 Blackwell 的 30 倍。这些是英伟达公布的性能说法;部署方案则解决另一个实际问题:如何将算力连接起来并投入运行。
运输可运行系统也是一项工程任务
运载已安装机架的集装箱,所需的不只是卡车上的空间。英伟达的技术设计涵盖结构载荷、设备固定、重量分布、重心、吊装点和搬运通道。设备在运输和安装过程中必须始终符合其机械、电气和冷却要求。
合作伙伴会在发货前记录配置和测试状态、固定设备,并在到货后重复规定的检查。工厂验证可能包括固件版本、电力检查、网络连接、传感器、冷却系统密封性和集成系统测试。固件是控制硬件运行的基础软件。
标准标签、电缆路径和维护空间,在设备启用后也同样重要。技术人员需要识别连接、接触设备并更换部件,而无需拆卸无关系统。可重复的布局能让运营商采用一致的单元规划扩建和维护。
集装箱适用于哪些数据中心项目
模块化数据中心在欧洲和台湾早已应用。德国的 JUPITER 超级计算机于 2025 年启用,采用约 50 个预制集装箱模块。台达开发了一款 20 英尺集装箱式 AI 数据中心,技嘉则在 2026 年台北国际电脑展上展示了 GADU 模块化数据中心解决方案。
英伟达将 DSX POD 定位于需要快速新增数百兆瓦算力的项目。对于吉瓦级园区,传统建筑仍是可选方案,大型永久性设施可以享受规模经济。永久设施尚在筹备时,集装箱也可以让 AI 应用先行投入运营。
电力快线总经理刘耀元曾提醒,快速安装集装箱设施并不意味着可以省去完整的供电和备用基础设施,这些设施必须在数据中心投入运营前准备妥当。他的观点凸显了剩余建设工作的核心地位:运营商必须协调工厂交付日期与目的地的准备进度。
英伟达尚未公布 DSX POD 的价格、各合作伙伴的具体供货分工或客户采购量。14 天的目标仍有待实际部署验证,首批交付在 2027 年初的具体日期也尚未公布。因此,客户规划项目时必须将公布的交付窗口与自身的公用设施、施工和调试进度相协调。
要点
- 英伟达于 2026 年 10 月 21 日在 GTC 柏林大会上宣布 DSX POD,计划于 2027 年初开始全球交付。
- 一个计算集装箱整合七个 Vera Rubin NVL72 机架和 504 个 Rubin GPU,并在发货前完成集成和测试。
- 英伟达的目标是在电力、冷却、网络和配套场地基础设施准备就绪后,最快 14 天完成部署。
- 台湾合作伙伴包括通过 Ingrasys 参与的鸿海、台达、技嘉、和硕、QCT 和纬创。
- 该设计采用 800 伏直流电输入,并在工厂集成计算、存储、网络、电力和液冷系统。
- 价格和客户订单量尚未公布;与此同时,传统数据中心建设仍与模块化方案并行。