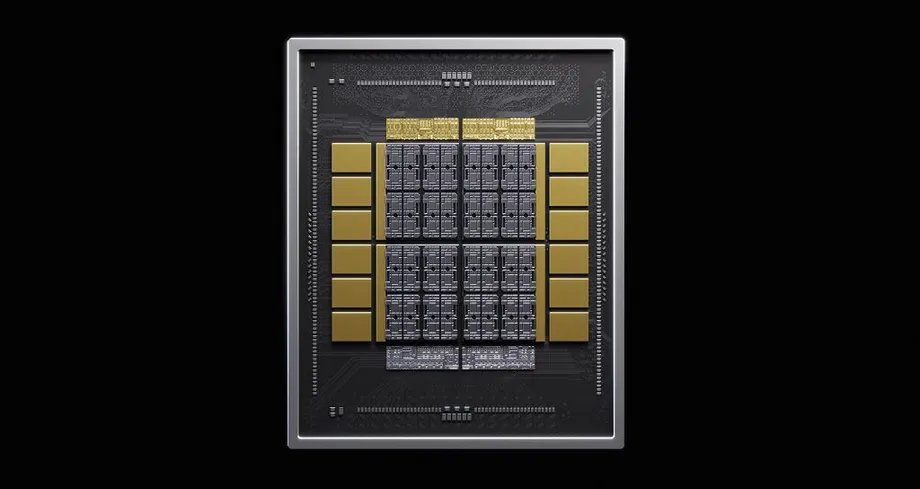
三家内存供应商采用共同制造方案
据 2026 年 10 月 18 日发布的行业消息,英伟达已要求三星电子、SK 海力士和美光在其下一代定制高带宽内存的基础裸片上采用台积电的 3nm 制程。据报道,三星设备解决方案部门在内部评估后接受了这一要求,使其台湾晶圆代工竞争对手参与到三星传统上自行负责的内存制造环节中。
目录
这款名为 NVHBM 的产品基于第七代高带宽内存 HBM4E。英伟达还希望供应商在内存裸片上采用第六代 DRAM 制造技术,即所谓的 1c 制程。此举旨在让不同供应商的内存表现更加一致,并减少对各家产品逐一进行认证所需的工程工作。
三星这一决定将其与台积电的既有合作从封装兼容性拓展至 HBM 制造。四年前,两家公司曾合作,确保三星内存能够通过台积电的封装技术连接图形处理器。如今,将内存堆栈中的关键芯片交由对方制造,进一步深化了这种合作。
英伟达的方案还改变了基础裸片的作用。NVHBM 将内存控制器,也就是负责调度数据流动的电路,从主处理器移至内存堆栈底部。这让基础裸片成为计算系统中更重要的组成部分,而不再只是连接内存与处理器的桥梁。
对三星而言,接受这一架构意味着将此前合在一起的两个决定分开:由谁制造存储信息的内存,以及由谁制造管理内存与处理器连接的逻辑芯片。三星仍将供应内存,而指定的基础裸片则由台积电制造。
内存堆栈内部有哪些变化?
HBM 将多层内存裸片堆叠在一起,并放置在高性能处理器旁边。这种堆叠设计可以让大量数据在短距离内传输,帮助 AI 加速器及时获得计算单元所需的信息。裸片是包含电子电路的一块独立硅片。
核心裸片用于存储数据。基础裸片位于其下方,负责连接和逻辑功能。在传统架构中,内存控制器仍位于主加速器裸片上。NVHBM 则将控制器移入基础裸片,为处理器腾出空间以容纳其他电路。
英伟达还采用一种称为 PHY 的定制物理接口来连接芯片。PHY 是负责发送和接收电信号的电路。NVHBM 的技术说明称,它以更窄的专有串行连接取代了标准 HBM 使用的宽并行接口,通过更少的连接以更高速度传输数据。
传统接口的规模有助于说明这种设计的吸引力。HBM4 有 32 个通道,每个通道宽 64 位,总宽度达 2,048 位。管理这些连接需要大量电路,以及芯片之间复杂的布线。NVHBM 旨在减轻这一负担,并简化中介层上的布线;中介层是位于芯片下方、用于连接芯片的层。
英伟达通过 NVLink Fusion 将 NVHBM 作为定制芯片合作伙伴可采用的构建模块。标准 HBM 仍属于独立的产品类别。选择 NVHBM 的合作伙伴将在自己的加速器系统中采用英伟达指定的控制器和连接设计。
英伟达为何要求供应商采用相同制程
英伟达提出的制造方案将台积电的 3nm 逻辑制程与用于内存层的先进 DRAM 制程结合起来。逻辑芯片和 DRAM 承担不同任务,也采用不同的制造方法。3nm 标识逻辑制造的一个世代,而 1c 标识 DRAM 技术的一个世代。
三星、SK 海力士和美光各自拥有不同的设计和生产方法。当加速器开发商希望从多家公司采购内存时,这些差异可能需要额外测试。采用统一的基础裸片制程,可以为开发商提供更一致的起点。
验证是指检查处理器、内存和封装能否在目标速度、功耗和可靠性要求下协同工作。针对不同实现重复这项工作会耗费工程时间。英伟达的方案旨在减少更换内存供应商时所需的单独集成工作。
美光将其即将推出的 DRAM 世代称为 1-gamma,大致对应三星和 SK 海力士术语中的 1c 世代。因此,统一的目标是将采用不同公司名称的制造世代汇聚起来,而不是让所有供应商的内存制程完全相同。
台积电将成为相互竞争的内存产品共同的制造合作伙伴。这种安排有望简化英伟达在不同供应商产品上的实现,同时也将一个重要生产环节集中到一家晶圆代工厂。三星评估备用制造方案,反映出确保基础裸片供应充足在实际生产中的重要性。
三星仍将自有工厂纳入布局
三星计划为标准 HBM 保留一体化制造模式。其 HBM4 和 HBM4E 产品采用三星自有的 4nm 制程制造基础裸片,并以 1c 制程制造核心裸片。内存层在韩国华城和平泽园区生产。
三星于 2026 年初开始量产 HBM4;据 10 月的相关报道,当时 HBM4E 正在进行量产认证。认证是用于确认产品是否已达到所需标准、可以稳定量产的测试阶段。
为包括 AMD 在内的其他客户定制的 HBM,预计也将继续采用三星的一体化模式。因此,采用 NVHBM 是针对英伟达特定需求作出的决定,并不代表三星全公司将不再内部制造基础裸片。
预计三星内存事业部将负责为台积电制造的基础裸片提供设计和优化支持。这将改变三星内部的职责分工。此前,系统 LSI 部门和晶圆代工业务传统上都参与了内部供应的基础裸片制造。
三星还在评估,如果需求超过台积电的产能,能否由自家晶圆代工厂生产 NVHBM 基础裸片。这一备用方案将保留另一种生产选择,不过据报道,英伟达目前的规格仍以台积电 3nm 制程为核心。
美光和 SK 海力士选择不同路线
美光的转变并不局限于英伟达的定制产品。该公司表示,与英伟达共同开发的 NVHBM 和标准 HBM4E 都将采用外部晶圆代工厂制造的基础裸片。预计这一制造工作将由台积电承担。
在 HBM4 产品中,美光将采用 1-beta 制程制造的内存裸片与内部制造的基础裸片搭配使用。HBM4E 则将内存层升级至 1-gamma 制程,并把基础裸片生产转至美光工厂之外。因此,美光改变了堆栈中的两个主要部分:采用更新的内存制程,同时引入外部逻辑芯片制造合作伙伴。
美光首席运营官曼尼什·巴蒂亚预计,NVHBM 将实现更高的平均售价和更强的利润率。他的理由是,HBM 本身已能以溢价销售,而定制所涉及的额外工作和功能会创造更多价值。因此,外包基础裸片制造与提高盈利能力的预期并不矛盾。
SK 海力士已经采用台积电的 12nm 逻辑制程制造 HBM4 基础裸片。行业消息显示,台积电 3nm 制程正优先用于 HBM4E 和未来的定制 HBM。这将把更先进的逻辑制造技术用于承担更多职责的组件。
今年早些时候,SK 海力士还在英伟达 GTC 活动上展示了基于 Stream DQ 技术的定制 HBM 概念。这一概念着重于持续管理数据并向处理器供数。三家供应商的共同方向,是让基础裸片在数据传输中发挥更积极的作用。
英伟达公布的性能数据意味着什么
英伟达表示,与标准 HBM4E 相比,NVHBM 每个堆栈的带宽最高可提高 30%,HBM 功耗则可降低 15%。带宽衡量的是单位时间内可传输的数据量。对于等待内存提供数据的 AI 处理器而言,更高带宽有助于提升性能。
简单来说,如果标准 HBM4E 堆栈在某一时段内传输 100 个单位的数据,英伟达所称的最高提升幅度可将其提高至 130 个单位。如果作为对比的内存功耗为 100 个单位,所称的降幅则会使 HBM 功耗降至 85 个单位。这些例子只是对百分比进行换算,并不代表具体上市产品的表现。
英伟达还称,这种设计最多可释放 XPU 计算裸片 25% 的面积。XPU 是计算处理器的广义称谓,包括定制 AI 加速器。将内存电路移走后,设计人员可以把更多硅片空间分配给计算功能。
另一份关于英伟达发布会的报道给出的数字是,主裸片的计算能力最高可提高 30%。这一数字衡量潜在计算资源,而 25% 指的是架构变化释放出的硅片面积。设计人员仍需决定如何利用腾出的空间。
据称,定制 PHY 可将该接口占用的面积最多减少 67%。一份技术评估根据引脚数量减少推算出了这一估值。英伟达关于带宽、功耗和面积的整体比较均以标准 HBM4E 为基准;当时这一代产品尚未上市。
对于 AI 服务而言,如果内存是性能瓶颈,更快的数据传输有助于加快响应生成。降低内存功耗则能让系统设计人员在电力预算内拥有更大余量。对整台服务器的影响还取决于处理器、工作负载、网络和散热等因素,而不仅是内存。
亚马逊将内存纳入英伟达更广泛的平台
亚马逊旗下安纳普尔纳实验室是首个公布的 NVHBM 合作伙伴。这家芯片设计部门为亚马逊云科技开发 Trainium 加速器,使英伟达得以向一家同时自行研发 AI 处理器的公司供应内存技术。
安纳普尔纳实验室副总裁纳费亚·布沙拉在公告附带的评论中谈到了合作目的:
我们期待通过这项技术合作,助力未来 AWS 基础设施设计。
预计安纳普尔纳的 Trainium 4 将支持 NVLink Fusion。关于 NVHBM 部署的报道称,它可能随 Trainium 4 或后续一代产品推出;亚马逊 NVHBM 实现方案所对应的具体芯片世代和商用时间尚未公开确定。
NVLink Fusion 为合作伙伴提供 NVLink Chiplet、NVLink-C2C、NVLink Switch,以及 MGX 系统和机架等技术。这些技术提供连接方案和系统设计,帮助定制处理器接入英伟达的计算基础设施。NVHBM 则将内存子系统纳入这一组合。
据报道,MediaTek 在 NVHBM 发布五天后采用了 NVLink Fusion,并计划向自己的 XPU 客户提供该技术。这为英伟达进入定制加速器项目市场开辟了另一条路径;博通和迈威尔也在这一市场展开竞争。迈威尔曾于 2024 年 12 月介绍过类似的内存控制迁移方案,因此客户采用和系统集成将成为竞争中的重要环节。
这一转变如何发展而来
NVHBM 的发展汇集了架构、供应商关系和客户采用方面的变化。这一时间线有助于解释三星 10 月的决定为何重要:英伟达先提出统一设计,随后内存制造商必须决定如何制造它。
- 2024 年 12 月:迈威尔提出了一个类似概念,涉及将内存控制功能移至不同位置。
- 2026 年初:三星开始量产 HBM4,SK 海力士则在 GTC 上展示了 Stream DQ 定制 HBM 概念。
- 2026 年 8 月 26 日:英伟达宣布将 NVHBM 纳入 NVLink Fusion,并公布安纳普尔纳实验室为首个合作伙伴。
- 五天后:据报道,MediaTek 采用了 NVLink Fusion,并计划向其 XPU 客户提供该技术。
- 2026 年 10 月 18 日:行业消息称,英伟达要求采用台积电 3nm 制程制造基础裸片,三星在内部评估后接受了这一要求。
三星的决定使制造计划更接近英伟达在不同内存供应商之间实现统一方案的目标。与此同时,三星继续投资自有基础裸片,保留了面向标准 HBM 和供应给其他客户的定制产品的另一条路线。
要点
- 据报道,英伟达希望三星、SK 海力士和美光为 NVHBM 基础裸片采用台积电 3nm 制程。
- NVHBM 将内存控制器从主处理器移入 HBM 堆栈的基础裸片。
- 三星接受了这一要求,但计划继续为标准 HBM 和其他定制产品保留内部制造。
- 美光计划为 NVHBM 和标准 HBM4E 外包基础裸片生产;SK 海力士已与台积电合作生产 HBM4。
- 英伟达称,与标准 HBM4E 相比,NVHBM 的带宽最高可提高 30%,HBM 功耗可降低 15%。
- 亚马逊旗下安纳普尔纳实验室是首个公布的合作伙伴;三星则在评估自家晶圆代工厂能否作为备用生产方案。