一款小巧的中国AI电脑瞄准高价竞争对手
Sipeed计划将搭载128 GB内存的MaixStation电脑定价在约3,999美元。这款电脑采用中国芯片制造商Axera的AX8860P,机身尺寸仅为11 × 11 × 3厘米,承诺以典型功耗40瓦在本地运行大型AI模型。它瞄准的竞争对手是Nvidia的DGX Spark,这款紧凑型AI系统的128 GB版本售价约为6,950美元。
目录
Axera于2026年10月13日在上海的一场工业展会上发布这款芯片,Sipeed也在会上展示了MaixStation。最初公布的性能数据颇为亮眼:运行拥有270亿参数的Qwen模型时,提示词处理速度比DGX Spark快25%,答案生成速度快30%,价格约为对手的一半。
Sipeed的MaixStation产品页面如今提供了更详细的信息。页面列出的数据为:处理Qwen3.8-27B提示词时,每秒592至677个token;生成答案时,每秒6至7个token。这些数据低于发布消息前后流传的范围;官方计划则显示,Kickstarter众筹活动将于2026年底启动。
这款电脑的吸引力很实际:小型电脑配备大容量内存,开发者、办公室和个人用户便可运行性能强大的模型,无需租用云计算服务或购买多张显卡。不过,购买决定不仅取决于芯片规格,也取决于最终软件、实测性能和交付时间表。
Axera为AX8860P配备了什么
AX8860系列采用6纳米制程,集成16个Arm Cortex-A55 CPU核心和一颗专用神经网络处理器(NPU)。NPU是专为执行AI模型所需的重复运算而设计的处理器。Axera和Sipeed称,该芯片采用FP4时性能最高可达每秒256万亿次运算,通常简称256 TOPS。
FP4以4位精度存储数值。减少位数可以降低模型所需内存,并加快计算速度,但模型和软件必须支持这种格式。Axera给出的数据针对稠密计算,并未采用一种名为稀疏性的技术,假设部分数值可以跳过计算。
这款芯片支持PCIe 5.0和256位宽的内存接口。Sipeed列出的规格包括LPDDR5X-8533内存、每个模组最高128 GB,以及每秒273 GB的带宽。Maix-V模组尺寸为78 × 78毫米,采用LPCAMM2连接器。
Cortex-A55核心负责运行操作系统及处理辅助任务,NPU则用于承担主要AI工作负载。Nvidia DGX Spark配有20个Arm核心,包括性能更强的Cortex-X925核心;AMD Ryzen AI Halo系列竞品则采用Zen 5 CPU。因此,计划同时进行AI推理和大量常规计算的用户,需要比较的不只是加速器。
128 GB内存为何比醒目的TOPS数据更重要
语言模型需要内存来存放数值权重,也就是模型在训练中学到的信息;模型回答请求时还需要存放临时工作数据。如果加速器速度很快,但内存不足,模型可能不得不拆分到多个设备上运行,或借助速度较慢的存储设备。
MaixStation拟推出的128 GB配置,与更大的DGX Spark属于同一内存容量级别。两者列出的带宽均为每秒273 GB。AMD Ryzen AI Halo系列则包括128 GB、带宽约为每秒256 GB的配置,以及价格更高、配备192 GB内存且带宽为每秒273 GB的版本。
内存容量决定能装下多少内容,带宽决定信息传至处理器的速度。稠密语言模型常规生成文本时,每生成一个新token,都需要读取大量模型数据。Token是文本的一个小单位,有时是一个词,有时只是词的一部分。
因此,Sipeed认为,高效利用内存可以让其256 TOPS处理器与Nvidia公布的更高算力数据一较高下。DGX Spark约1,000 TOPS的FP4评级采用了稀疏性;其稠密FP4数据约为每秒500万亿次运算。实际应用速度还取决于软件能否高效地让硬件持续工作。
官方基准测试页面呈现的数据范围较窄
Sipeed将测试分为预填充和解码两个阶段:预填充是模型处理用户提示词的阶段,解码则是模型生成答案的阶段。预填充更快,可以缩短答案开始出现前的等待时间,尤其是在处理长文档时。解码更快,则能让答案在开始生成后更快呈现。
针对稠密FP4格式的Qwen3.8-27B,官方页面列出的MaixStation预填充速度为每秒592至677个token,DGX Spark为550个。这意味着MaixStation领先约8%至23%。MaixStation的解码速度为每秒6至7个token,但官方图表的文字没有提供该模型在DGX Spark上的解码基准数据。
针对混合专家模型Qwen3.6-35B-A3B,Sipeed列出的预填充速度为每秒2,664至3,256个token,DGX Spark为2,368个。计算得出的领先幅度约为13%至38%。解码速度方面,MaixStation为每秒34至37个token,DGX Spark为34个,表现从持平到领先约9%不等。
混合专家模型每生成一个token时,只会启用网络中的一部分。这有助于解释为何其生成速度可能远高于参数总量相近的稠密模型。这两类模型每个token所需的计算量并不相同。
Sipeed称,页面展示的是当前较为保守的实测数据,AX8860P仍在调试优化中。图表注明测试采用FP4格式,并关闭了多token预测(MTP)。MTP是一种通过同时预测多个后续token来加快生成速度的技术。
为何需要谨慎比较早前的速度数据
Sipeed此前公布的基准测试数据更高:Qwen3.8-27B预填充速度为每秒1,400至1,600个token,解码速度为每秒15至17个token;DGX Spark对应基准分别为1,300和13个。对于混合专家模型,Sipeed此前给出的预填充速度为每秒6,300至7,700个token,解码速度为每秒80至88个;DGX Spark对应数据为5,600和80个。Sipeed后来还表示,MaixStation在两个阶段都领先约10%,并称显示更大领先幅度的较新测试结果尚未正式发布。
官方页面公布的绝对速度较低,因此测试条件尤其值得关注。提示词长度、同时处理的请求数量、数值格式、运行时软件和驱动版本都可能影响测试结果。报道引用的DGX Spark独立测试显示,在未使用推测解码的情况下,运行Qwen3.8-27B时速度约为每秒11.5至11.6个token;预填充速度则因软件不同,在每秒840至1,900个token之间变化。
一个简单的内存带宽计算可以说明,为何早前公布的每秒17个token这一数据受到关注。如果运行中的模型占用约16 GB内存,用每秒273 GB除以16 GB,结果约为每秒17个token,且尚未计入其他内存流量。要达到这一速度,就必须极高效地利用公布的带宽。
模型的实际内存占用也很重要。270亿个参数各用4位存储,仅权重就约占13.5 GB;数值缩放数据和其他存储需求还会增加实际工作集大小。详细且可重复的测试能帮助买家将速度数据与具体的模型配置对应起来。
口袋大小的机箱,配备标准存储接口
MaixStation公布的尺寸对应363立方厘米的体积。Sipeed将其与体积为1,125立方厘米的DGX Spark相比,称计划推出的机箱体积约为对方的三分之一。该公司表示,这款电脑可通过USB-C由符合要求、额定功率为65瓦的移动电源供电。
官方页面列出的MaixStation典型功耗为40瓦,DGX Spark为120瓦。这些是Sipeed公布的典型负载功耗。最初有关AX8860的报道也称专用模组功耗为40瓦,因此,功耗测试的测量范围也是日后评测中值得关注的信息。
接口包括10G SFP+网络接口、USB-C、MCIO 8i连接器,以及用于SSD的标准M.2 2280插槽。标准存储接口让买家可以方便地扩充空间,以存放模型文件;这类文件很快就可能占用数百GB。
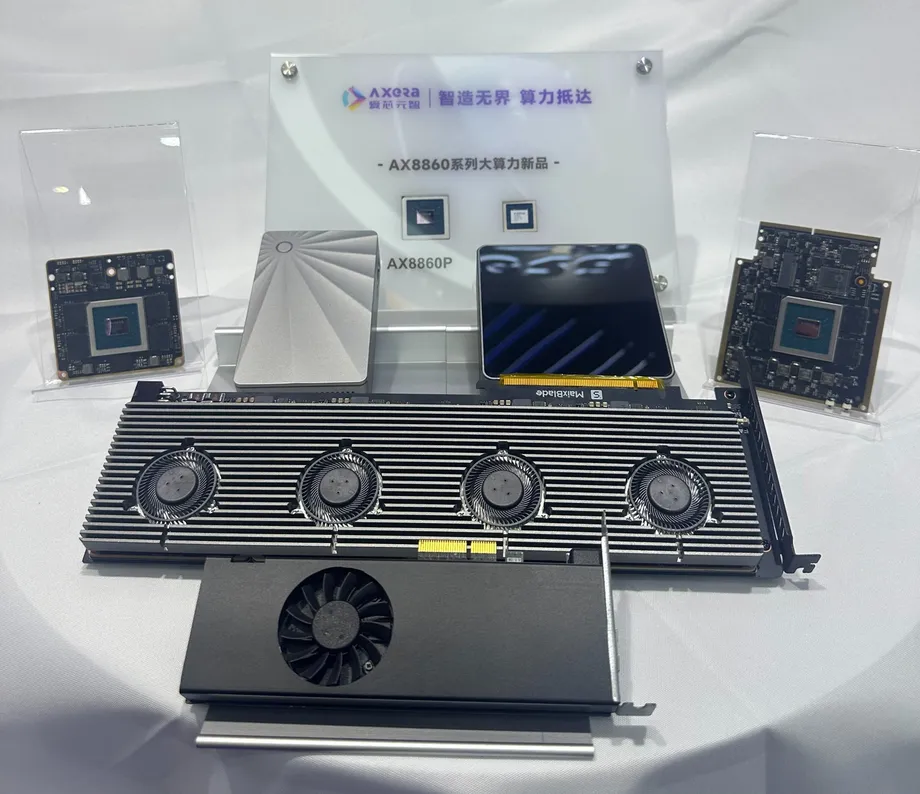
Axera的硬件规划不止于小型台式机,还包括模组、单芯片PCIe卡,以及配备四颗芯片、四个风扇和标准8针电源接口的扩展卡。Sipeed将MaixStation Pro和MaixBlade与512 GB或更大容量的配置联系起来。
更多芯片有望提升容量,但扩展能力仍只是宣称
Sipeed称,MaixStation最多可在无需外置交换机的情况下连接8个节点,芯片间连接的标称速率为每秒256吉比特,并可扩展至每秒384吉比特。DGX Spark使用每秒200吉比特的连接来互连系统;四台Spark组成的配置则需要外置交换机。
吉比特和吉字节的区别很重要。速率为每秒256吉比特的连接,换算后原始速率为每秒32吉字节,尚未扣除开销。每秒273吉字节的内存带宽描述的是每台机器内部速度更快的另一种连接。
Axera公布的数据称,两颗芯片合计可达512 TOPS,四颗可达1,024 TOPS,并宣称扩展效率约为80%。四芯片扩展数据来自实验室模拟。将模型分配到多个处理器上也会产生通信和同步开销,因此,应用速度并非简单地把各处理器的峰值算力相加就能得出。
Axera的路线图列出了性能最高可达500 TOPS的AX8950,以及性能超过700 TOPS的AX8970。这些计划中的处理器将带来后续升级选择,但MaixStation眼下的卖点仍取决于AX8860P及其软件。
软件承诺是日常使用体验的关键
Sipeed列出的软件包括Debian 13和Linux 6.18,并支持vLLM、SGLang、PyTorch、llama.cpp和Ollama。这些工具可帮助用户加载模型、处理请求,并让AI应用连接硬件。该公司还宣传了兼容OpenAI和Anthropic的API,现有应用可通过这些接口向本地设备发送请求。
Sipeed在产品常见问题页面中解释,常见框架名称背后是专为Axera硬件编写的软件:
SGLang和vLLM通过定制的硬件加速后端运行,其内核采用AXDSL编写。
内核是负责在加速器上执行核心计算的小型软件组件。Sipeed称,用户可以直接加载受支持的Hugging Face模型;新的模型架构则可能需要用AXDSL编写内核。该公司承诺公开发布内核和开发工具,并表示正在推进开放AX8860软件开发工具包。
该公司称,设备启动后即可使用模型和浏览器界面,并列出了编程代理、文档处理、视频生成和机器人等用途。PCIe卡将首先支持Linux主机;是否支持Windows取决于需求。发布时,NPU工具链预计将于10月底推出。
价格和交付时间如今与众筹计划挂钩
Sipeed预计128 GB版本售价为3,999美元,比售价6,950美元的DGX Spark便宜约2,951美元,即42%。折扣幅度可观,但不到一半。MaixStation的定价也将接近配备128 GB内存的AMD Ryzen AI Halo,后者售价约为3,999.99美元。
产品发布计划已从最初预计于2026年出货有所调整。目前已开放预订,但官方常见问题页面将Kickstarter众筹活动安排在2026年底。Sipeed表示,计划在众筹活动结束后三个月内发货。
- 2026年10月13日:Axera在上海发布AX8860系列,Sipeed展示MaixStation。
- 2026年10月底:Sipeed预计推出NPU工具链。
- 2026年底:Sipeed计划启动MaixStation Kickstarter众筹活动。
- 众筹活动结束后三个月内:Sipeed公布的目标发货时间。
Sipeed尚未确认最终零售价、确定的交付日期,也没有公布经过独立验证的MaixStation性能数据。产能、支持服务,以及512 GB版Pro机型的价格和上市时间也仍未确定。公司计划在众筹期间提供远程访问和评测机,届时潜在买家将有机会进一步检验相关说法。
要点
- MaixStation计划以约3,999美元的价格提供128 GB内存和Axera AX8860P处理器;该处理器在稠密FP4下的标称性能为256 TOPS。
- Sipeed公布的内存带宽为每秒273 GB,典型功耗为40瓦,机身尺寸为11 × 11 × 3厘米。
- 官方基准测试页面显示的绝对速度低于此前公布的数据,结果因模型和处理阶段而异。
- 软件支持依赖Axera定制的加速后端;公司承诺公开发布开发工具和更多代码。
- Kickstarter众筹计划于2026年底启动,Sipeed称将在活动结束后三个月内发货。
- 独立测试结果、最终价格和交付承诺,将决定这套系统与Nvidia及AMD竞品相比的实际表现。