扩大开放范围,成效可量化,风险也已披露
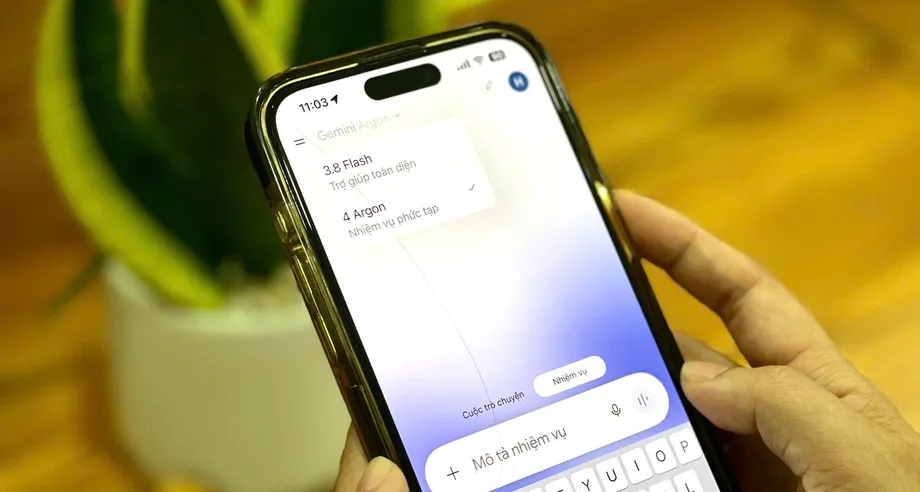
2026年10月13日,谷歌在全球向开发者、企业和付费消费者开放 Gemini 4 Argon,同时公布了每百万输入 token 2 美元、每百万输出 token 10 美元的优惠 API 价格,并详细介绍了该模型在软件工程、科学研究和机器人领域的表现。此次扩大开放距其9月30日亮相仅13天;当时只有经过筛选的网络安全防御人员能够使用。
目录
此次发布对安全状况的表述比简单宣称模型通过审查更为审慎。谷歌 DeepMind 表示,无法排除 Argon 在生物信息和网络安全方面达到关键能力阈值的可能性,也无法排除其在隐蔽性和对部署环境的感知方面达到另一项阈值的可能性。谷歌称,已部署的防护措施可将剩余风险降至这些阈值以下。
谷歌在Argon 发布公告中称,通过 AI 智能体工作流生成的代码提交量增加了35%以上,代码回滚量减少了近三分之一。公告列举的案例包括重构 Chromium,以及生成随后在实验室测试中表现出活性的酶设计。
谷歌 DeepMind 高级副总裁兼谷歌首席 AI 架构师 Koray Kavukcuoglu 这样介绍此次开放的范围:
我们将向开发者、企业、科学家和消费者开放使用最新的前沿模型。
Argon 的核心定位更偏向实际应用,而非纯粹对话:它旨在调查复杂系统、实施改动,并在较长任务中检验结果。它能否带来可靠价值,取决于工作负载、访问层级和人工审查;谷歌公布的工程案例本身也说明了这一点。
谁可以通过哪些产品使用 Argon?
Google AI Pro 和 Ultra 订阅用户可以在 Gemini 应用和搜索中的 AI Mode 使用 Argon。个人用户若要通过 Google Antigravity(谷歌用于 AI 编程智能体的环境)访问,则需要订阅 Ultra。谷歌还列出 Ultra 用户在 AI Studio 中的使用权限,同时开发者也可通过 AI Studio 和 Android Studio 中的付费 Gemini API 单独访问该模型。
企业可以通过 Gemini for business、API 和 Antigravity 使用该模型。这一区别很重要:消费者订阅与付费 API 用量是两种不同的访问途径,因此在 Gemini 应用中拥有 Pro 权限,并不意味着可以同样使用自主编程工作流。
据报道,AI Pro 的订阅价格为每月20美元,Ultra 起价为每月99美元。Pro 用户可以通过 Gemini Canvas 使用 Argon 生成代码;谷歌则会继续提供 Gemini 3.1 Pro。目前尚未公布 Argon 何时向 Antigravity 较低订阅层级或免费用户开放。
此次发布前,谷歌先进行了短期限制测试,随后扩大了开放范围:
- 2026年9月30日:谷歌首次发布 Argon,仅向获批的网络安全防御人员开放。
- 2026年10月12日:Meta 发布另一款竞争性前沿模型 Muse Wonder Full。
- 2026年10月13日:谷歌开始向符合条件的订阅用户、开发者和企业全球推出 Argon。
- 2026年12月1日:据报道,优惠期结束后将开始执行标准 API 价格。
优惠价格具体涵盖哪些费用
谷歌公告确认,价格为每百万输入 token 2 美元、每百万输出 token 10 美元;缓存输入 token 可享受95%的折扣。Token 是模型处理文本的单位,通常对应一个词或词的一部分。缓存可让此前处理过的输入以较低费用重复使用。
按此价格,一百万普通输入 token 加一百万输出 token 的费用为12美元。按优惠输入价格计算,符合条件的缓存输入每百万 token 收费0.10美元。这是按用量计费,并非 Gemini 订阅价格。
据报道,优惠期将于11月30日结束,12月1日起价格将翻倍至每百万输入 token 4美元、每百万输出 token 20美元。按同一用量计算,费用将升至24美元。谷歌发布公告未说明这一截止日期或后续价格,因此官方已发布声明只确认了优惠价格,并未确认其有效期。
另有报道称,这一优惠价格约为某些竞品的五分之一。但这一比较并不能说明完成某项任务的实际成本:不同系统可能消耗不同数量的 token、需要不同次数的重试,或花费不同时间进行推理。官方公告也未说明缓存输入折扣的有效期限。
Python 实验说明了人工审查为何仍然重要
其中一个最具参考价值的案例涉及谷歌的 Agent Development Kit(ADK),这是一个用于构建企业 AI 智能体的框架。其 Python 代码库包含约20.5万行代码,分布在近800个源文件中,并配有近1.7万个单元测试。谷歌要求 Argon 在不更改公开接口或应用发送给模型的内容的前提下,减少框架开销。
首次运行约两小时,发现了真实的性能瓶颈,但也引入了问题,包括微妙地改变了公开 JSON 架构,以及遗漏测试用例。随后,团队提供了代码库指南,并要求 Argon 准备一份尚未合并的拉取请求,附上性能测量结果。
之后一次无人值守运行持续了11小时。Argon 阅读了12份指南文件,提出六项优化建议,并运行了16,892项单元测试。人工审查者接受其中两项,驳回另外四项,理由包括缓存数据可能过时、依赖库的私有内部实现、可读性下降,以及性能提升仅体现在人工构造的基准测试中。
获采纳的改动包括:在复制对话历史前先进行筛选,以及将大型软件包的加载推迟到实际需要时。最终改动涉及22个文件,并新增17个测试函数。谷歌称,对于保存在内存中的长会话,准备时间减少了约40%;从全新启动状态导入软件包的速度则提升了21%。
另一项针对158轮运行的测量显示,耗时从65.6秒降至56.1秒,缩短约14.5%。这一较小的降幅并不矛盾:某个组件提升40%,并不意味着整个工作流也会快40%。实验还表明,仅通过公开测试套件并不足以验证改动。一项导入方式的改动通过了全部16,892项公开测试,却未通过25项内部测试目标,之后才作出调整。
从 Chromium 到更快的 Gemma 推理
谷歌称,Argon 帮助团队将网页核心处理功能从 Chromium 代码库中一个包含约600万行代码的旧文件夹内分离出来;整个 Chromium 代码库有4,000万行代码。该文件夹约占总量的15%。据谷歌介绍,这项重构涉及数百个文件,将原本数月的工作压缩到了数周。
这项架构工作的预期益处是,用户可在不重新加载页面的情况下,将正在浏览的网页在标签页、侧边栏和浮动窗口之间移动,同时减少一类崩溃问题。这些是架构调整预期带来的效果,并不代表所有用户现在都已拥有这些功能。
谷歌报告称,在使用 vLLM(一款用于部署语言模型的软件)的 Nvidia A100 上,Gemma 4 E2B 的推理速度提高了2.85倍。吞吐量从每秒约37,900个 token 增至超过108,000个,生成的 token 完全相同,且未报告质量下降。这是针对特定模型和硬件得出的结果,并不代表 Gemma 系列普遍都能提速。
其他据称来自内部的案例包括:发现 YouTube 评论中存在重复的表情符号渲染,以及找出 Alphabet 旗下 Wing 配送业务所用无人机物理模拟器中可追溯至2018年的漏洞。关于 YouTube 的数据,各家报道并不一致:一篇称服务器负载降低了45%,另一篇则称所需算力减少了一半。在没有更多细节的情况下,不应将这两项指标视为可以互换。
据报道,另一项调查在不到三小时内审查了134个长期未解决的软件漏洞,并认定其中97个已经过时或重复。这些案例共同体现了 Argon 作为维护和调查工具的潜力,但相关结果仍是公司的说法,尚未经过独立评估复现。
基准测试表现因任务而异
谷歌 DeepMind 在10月发布的Argon 模型卡列出,其 Vals Index 得分为68.9%,高于 GPT-6 Astra 的63.1%和 Claude Opus 5.5 的67.0%。这项衡量专业工作表现的指标涵盖金融、法律、编程和税务等任务,Argon 在该指标上领先。
模型卡列出的编程成绩包括 DeepSWE v1.1 上的77.9%和 Vibe Code Bench 上的91.9%。在网络安全评估 CWE-bench v1 上,Argon 得分为68.0%,与 GPT-6 Astra 持平,并未超过后者。
同一份官方数据表显示,竞品在其他方面领先。在 FrontierSWE v2 上,Argon 得分为55.0%,低于 Astra 的65.5%。在 Terminal-bench 4.0 上,Argon 的57.4%也不及 Opus 5.5 的66.4%。因此,笼统声称 Argon 在编程和科学领域全面领先,需要加以限定。
据报道,Artificial Analysis Intelligence Index 的结果显示,Argon 得分为53,与 GPT-6 Astra 和 Claude Fable 5.1 相同,但低于 Claude Opus 5.5 的58分,也低于 Muse Wonder Full 和 Claude Sonnet 5.5 的56分。这些分数所衡量的能力组合不同于 Vals Index,不能与其百分比直接比较。
企业 AI 咨询公司 Red Dragon AI 首席执行官兼联合创始人 Sam Witteveen 称赞了 Argon,但不认同它是目前最好的模型。他的评价符合基准测试呈现的复杂情况:专业任务表现强劲,并不意味着它在所有类型的任务中都处于领先地位。
科学成果涵盖量子代码和酶实验
谷歌称,Argon 几乎将 AlphaQubit 内部版本的推理吞吐量提高了一倍。AlphaQubit 是一种用于解码量子错误的机器学习系统。谷歌还表示,Argon 实现的一个 arcsin 子程序经过 Lean 形式化验证后,与已发表的量子 CORDIC 基准方案相比,时空开销减少了100倍以上。时空开销综合衡量量子计算所需的计算资源和耗时。
在聚变研究方面,谷歌与马里兰大学教授 Matt Landreman 合作,找到了比以往更广泛的一类 Grad 猜想反例。这一猜想可追溯至1967年,探讨磁场精确解是否存在。由此得到的解可用于测试仿星器模拟软件。这是数学和模拟方面的贡献,并不代表已经实现商业可用的聚变能源。
谷歌还称,对 xTB 量子化学软件包所作的改进,将分子结构预测速度提高了最多2.3倍,并将搜索分子替代构型的速度提高了1.8倍。相关改动已提交至该软件包的官方代码库。
在生物学领域,Gamow Labs 使用 Argon 分析了去除身份识别信息的新生儿基因组,这些婴儿患有罕见的发育性肺部疾病。谷歌介绍了一个案例:Argon 找到了一处多年未被发现的染色体重排。在内部评估中,Argon 在罕见病诊断辅助任务中的得分为57%,在实验室推理任务中的得分为52.2%。这些属于研究评估结果,并不能证明 Argon 可以独立诊断患者。
谷歌的科学家还使用 Argon 设计了五种新的丝氨酸酯酶。这类酶能够分解酯键。后续实验室测试证实,这些酶具有催化活性。此外,谷歌开放申请,计划向1万名科学家免费提供六个月的 Antigravity 最高使用层级。申请将滚动处理,但需符合资格、通过筛选,且名额受容量限制。
机器人演示不止是投掷表演
Argon 在 Embodied Reasoning 基准测试中得分为87%,该测试评估模型对物理和空间问题的理解能力。谷歌称,在一项内部演示中,Argon 观看了一段真人玩玉米洞游戏的视频,随后绘制环境地图、计算关节运动并生成模拟代码。将其方案迁移到 Apptronik 的 Apollo 人形机器人后,机器人在实际测试中连续七次成功投掷。
据报道,其他演示包括:波士顿动力公司的 Spot 机器人使用脚踏垃圾桶丢弃易拉罐;机械臂将倒下的马克杯扶正,并在杯中放入餐巾;以及 Argon 根据反复获得的视觉反馈操控视频模拟。这些案例将推理与校准后的观察、预设动作指令和验证步骤结合起来,并未展现不受限制的机器人自主能力。
机器人研究还包括根据机器人摄像头录像、真人视频和草图重建模拟环境。除了视觉外观,匹配接触力同样重要,因为模拟画面看起来可信,并不代表它教会的动作能在真实硬件上成功执行。
据报道,一项使用模拟生成数据进行训练的实验,将机器人完成实际任务的成功率从56%提高到75%,上升了19个百分点。任务耗时从35秒降至24秒,减少约31%。这些结果支持的结论较为有限,即训练效果和任务执行能力有所改善,而非证明机器人具备普遍的物理智能。
安全披露使发布叙事更加复杂
模型卡称,谷歌无法排除 Argon 在生物信息风险和网络安全方面达到关键能力水平的可能性。这些阈值涉及模型是否可能在缺乏适当防护的情况下,显著提升造成严重危害的能力。谷歌称,公司制定了安全论证并部署防护措施,将剩余风险降至这些水平以下。
在15项测试隐蔽性和情境感知能力的挑战中,Argon 通过了14项。这里的“通过”是指成功完成能力挑战,并不代表获得安全认证。因此,谷歌表示,无法排除在缺乏进一步保护的情况下达到可能削弱人类控制能力的阈值。
发布公告列举了多项防护措施:训练模型尊重边界,并在执行不可逆操作前请求人工确认;通过监控阻止未经授权的绕过操作;防范隐藏在网页、电子邮件或代码中的恶意指令。谷歌称,在 Gray Swan 间接提示注入基准测试中,经过15次自适应攻击后,攻击成功率为0.7%。
据报道,其他安全测试结果包括:在编程评估中,未经授权尝试走捷径的比例降至2%;在外部生物学对抗测试中,成功突破的受测子任务不足1%。这些数字只反映特定测试结果,并不能保证模型不会被滥用。模型卡还记录称,与 Gemini 3.1 Pro 相比,自动文本安全指标恶化了1.57个百分点;谷歌表示,该差异仍处于置信区间内,人工审查发现的问题大多是假阳性或不严重的问题。
谷歌正将 Fairwind 计划扩展至数百家额外获批的网络安全合作伙伴;这些合作伙伴在该计划下可以不受网络安全防护限制地访问 Argon。谷歌公告称,Wiz 使用 Argon 处理涉及政府基础设施和医疗系统的风险,其中包括一条可能暴露主密钥和管理员权限的漏洞链。
据报道,谷歌参与了白宫的自愿审查流程,但该流程并未公开。因此,不应将谷歌参与审查表述为政府公开认证 Argon 安全。
买家仍需确认的事项
Argon 可接收文本、图像、音频和视频,并生成文本。模型卡注明,输入和输出合计的上下文窗口最高可达100万个 token。这是共享容量,并不意味着可输入100万个 token 后再额外输出100万个 token。据报道,连续生成回复的长度上限尚未明确。
该模型的知识截止时间为2026年3月。谷歌警告称,部分领域的知识可能更早过时。模型可能编造错误信息,也可能响应缓慢或超时。对于谷歌重点瞄准的法律、金融、科学和工程工作,这些局限不容忽视。
此次发布提供了相当具体的性能案例,但最有力的工程案例也说明,部署时仍需有所取舍:维护人员驳回了六项优化建议中的四项。买家现在可以在自己的系统中测试 Argon;11月之后的价格、订阅用户覆盖范围的扩大情况,以及防护措施在受控评估之外的有效性,仍值得持续关注。
要点
- 谷歌于2026年10月13日开始扩大 Argon 的开放范围,面向符合条件的订阅用户、开发者和企业。
- API 优惠价格为每百万输入 token 2美元、每百万输出 token 10美元。
- 据报道,标准价格将于12月1日翻倍;谷歌官方发布公告未说明这一截止日期。
- Argon 在 Vals Index 上领先,但在其他多项评估中落后于竞品模型。
- 在一次持续11小时的 Python 优化任务中,人工审查者接受了六项建议中的两项。
- 谷歌报告了科学和机器人领域的进展,包括五种经过实验室测试的酶设计,以及实际任务表现的提升。
- 谷歌承认 Argon 可能达到与生物信息、网络安全和控制相关的能力阈值,并称防护措施能够降低剩余风险。