这家手机制造商刚刚改变了 AI 推理
在一个令科技行业颇感意外的周一早晨,小米做了一件少有人预料到的事。这家以平价智能手机、电动滑板车和家用空气净化器闻名的公司宣布,自己突破了人工智能速度的一项重大瓶颈。其全新 MiMo-V2.5-Pro-UltraSpeed 服务模式在一个万亿参数模型上实现了每秒生成超过 1,000 个 token,现场演示峰值接近 1,200 个。这并非精简版模型,而是完整的旗舰模型 MiMo-V2.5-Pro,一款在编程基准测试中可与 Claude Opus 媲美的前沿 AI 系统。
目录
这项声明令人震惊之处不只是速度,还有实现这一速度的硬件。小米使用一台配备八块通用 GPU 的标准节点达到了这些指标,这类设备任何一家大型云服务商都能提供。没有定制芯片,也没有餐盘大小的专用芯片,只有运行在开发者今晚就能租用的硬件上的软件创新。
参数是定义 AI 模型如何处理信息的内部数值权重。万亿参数意味着模型能够识别文本和代码中极其复杂的模式。Token 是模型读取和生成的文本片段,大致相当于四分之三个单词。每秒生成超过 1,000 个 token,意味着这个庞大的“大脑”正以此前被认为没有专用硬件就不可能实现的速度运行。
多年来,更快 AI 推理的竞赛一直由资金雄厚、设计定制芯片的初创公司主导。小米刚刚证明,在标准设备上进行巧妙工程优化就能实现超越。此项成果也引出了一个尖锐的问题:当智能的软件优化能够在易于获取的基础设施上带来更出色的结果时,昂贵的专用硬件是否仍有必要。
每秒 1,000 个 Token 究竟意味着什么
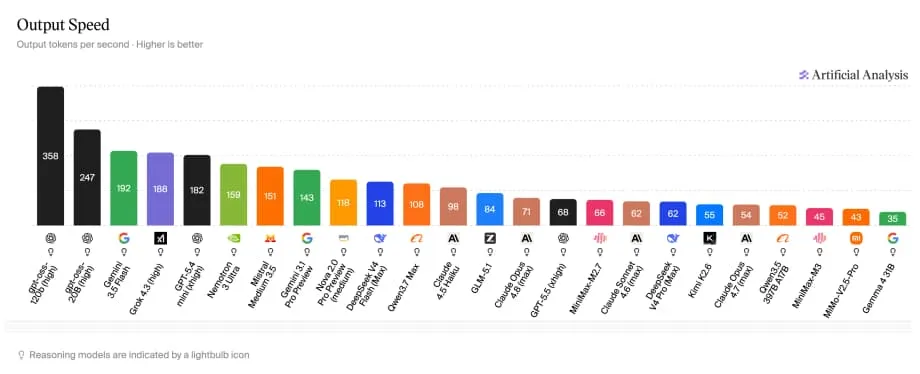
要理解这个数字为何重要,不妨看看普通用户如今的体验。根据 Artificial Analysis 的基准测试数据,为大多数 ChatGPT 对话提供支持的 GPT-5.5 每秒生成约 68 个 token。Claude Opus 4.6 的速度约为每秒 71 个 token,Anthropic 体量更小的 Haiku 模型则达到每秒 98 个。谷歌 Gemini Flash 的速度更快,为每秒 192 个 token。MiMo-V2.5-Pro-UltraSpeed 则能在一个万亿参数模型上达到每秒 1,000 个 token,速度接近数百万人每天使用的聊天机器人 15 倍。
每秒 68 个与 1,000 个 token 之间的差距并非小幅提升,而是代表着完全不同的性能等级。以目前面向消费者的速度,用户需要等上几秒才能看到一段文字逐渐显示出来。按照小米的新速度,一整页分析内容几乎能瞬间呈现。对于运行编程智能体的开发者而言,这一差异将体验从延迟的来回交互变成近乎实时的协作。
Token 是大型语言模型的基本计量单位。用户输入提示词后,模型会将文本拆分成 token 进行处理。模型回复时,则会逐个生成 token,并根据此前的全部内容预测下一个 token。模型生成 token 的速度越快,响应就越灵敏,也越能在严格的时间限制内完成任务。速度还决定了服务器能够同时处理多少请求,直接影响企业的成本和扩展能力。
MiMo-V2.5-Pro 早期推出的 Flash 模型已经能以每秒 150 个 token 的速度生成回复,约合每秒 110 个单词,超过人类最快的阅读或说话速度。UltraSpeed 大幅抬高了这一上限,其生成速度远超人类认知处理速度,也让此前不可能实现的机器驱动工作流程成为可能。
小米如何超越定制芯片巨头
AI 推理速度瓶颈吸引了数亿美元投资,众多公司正致力于开发专用硬件。Cerebras 设计了一款晶圆级芯片,尺寸约如餐盘,片上集成 44GB 内存,以消除带宽限制。该设计在 Meta 的 Llama 3.1 405B 模型上实现了每秒 969 个 token。这个模型有 4,050 亿参数,不到 MiMo-V2.5-Pro 规模的一半,尽管这一成绩依然令人瞩目。Groq 打造了定制语言处理单元架构,根据模型不同,可实现每秒 300 至 750 个 token 的速度。这两套系统都无法运行在开发者可以从 AWS 等服务商租用的标准云硬件上。
小米的做法则彻底颠覆了这一模式。公司与推理合作伙伴 TileRT 联手,通过其所称的“极致模型系统协同设计”实现了这一纪录,也就是对 AI 模型及其服务软件引擎进行协同优化。最终,一个万亿参数模型在通用 GPU 上的运行速度超过了专用芯片。如果独立测试能够证实这些基准数据,这项成果就表明,软件创新可以克服许多人认为必须依赖定制芯片才能解决的硬件限制。
这一进展具有实实在在的经济意义。定制芯片需要巨额资本支出、漫长的设计周期和专业制造能力。通用 GPU 则受益于规模经济、广泛供应,以及 NVIDIA 和其他厂商持续进行的迭代改进。小米通过软件解决推理问题,或许已让更多人能够获得此前只有资金雄厚、拥有专有硬件的实验室才能实现的速度。
在 Hugging Face 上发布 FP4-DFlash 检查点,又为这一技术的普及增添了新的维度。世界各地的研究人员和开发者如今都能检查、测试和调整底层模型,无需购买专有硬件或申请企业许可证。社区验证将决定这些技术能否广泛应用于不同模型和场景。
推动 UltraSpeed 的三项技术
这项突破依赖三项相互配合的技术。单靠其中任何一项都无法创造速度纪录,但三者结合后,性能便突破了每秒 1,000 个 token 的门槛。
第一项技术是 FP4 量化。大多数大型模型以 16 位或 8 位数值精度运行,这意味着每个参数需要占用两字节或一字节内存。小米将构成万亿参数模型大部分的专家层压缩至 4 位精度。此举缩小了内存占用,降低了带宽压力,使数据能够在系统中更快流动。量化的风险在于质量损失,因为降低精度可能削弱模型的推理能力。小米采用了精细的处理方式:只压缩专家层,其余模型部分仍保持完整精度。公司称,由此造成的质量损失接近于零。
第二项技术是 DFlash 推测解码。传统的推测解码使用较小的草稿模型快速猜测接下来的几个 token,再由大型模型并行验证这些猜测。DFlash 完全省去了顺序生成草稿的步骤,而是在一次前向计算中填充整块被掩码的位置。在编程任务中,大型模型每轮验证平均接受 8 个候选 token 中的 6.3 个。这意味着每一步可以推进 6 个 token,而不是 1 个,大幅提升了生成速度。
第三个组成部分是 TileRT 本身。这一推理引擎将整个计算流水线持续驻留在 GPU 内。标准服务系统通常逐个启动算子,导致执行过程中出现细小间隙。TileRT 消除了逐个算子启动所产生的开销,让数据流动不中断。压缩后的模型权重与先进的解码策略相结合后,该引擎得以维持此前标准硬件无法企及的吞吐水平。
小米将这种组合称为“极致模型系统协同设计”,这一说法恰如其分。每一层优化都强化了其他部分,最终效果超越了任何单项技术单独所能实现的水平。
速度为何能开启全新应用场景
如果不能带来新的应用,单纯的基准测试成绩就毫无意义。达到每秒 1,000 个 token 后,MiMo-V2.5-Pro-UltraSpeed 为许多较慢系统无法实现的应用打开了大门。
不妨看看开发者如今如何使用大型语言模型完成复杂任务。面对棘手的编程问题时,用户通常只能等一个答案,并希望它是正确的。有了 UltraSpeed,同一用户可以在相同的实时窗口内并行运行数十条推理路径,并在后台自动验证和自我纠正。模型可以同时探索多种解决方案,而不是只沿着一条思路推进。这一能力从根本上改变了 AI 的角色,使其从顺序式助手变成并行问题解决者。
对延迟有严格要求的行业将立即受益。欺诈检测系统必须在毫秒内评估交易;实时交易信号生成不能承受数秒延迟;自主智能体循环需要 AI 系统快速完成观察、决策和行动,而消费级聊天机器人无法提供所需速度。每秒 68 个 token 时,这些应用会遭遇令人沮丧的瓶颈;达到每秒 1,000 个 token 后,它们便能在标准云基础设施上落地。
即使在日常编程工作流程中,速度也会改变开发者的心理感受。过去,开发者只能盯着屏幕等待推理完成。输出速度接近甚至超过每秒 1,000 个 token 后,等待实际上消失了。交互方式从提出请求、等待回复,转变为与 AI 搭档真正实时协作。需要快速分析患者数据的医疗应用,以及处理实时市场数据流的投资平台,都能从这种响应能力中立即获得实际价值。
访问方式、定价与开源发布
小米没有将这项技术锁在门后。公司推出了限时 API 试用,时间为 2026 年 6 月 9 日至 6 月 23 日。用户需提交申请,获批并无保证。企业用户和具有明确业务需求的专业开发者将优先获得使用资格。由于高速推理资源有限,每个账号每天最多可加入队列十次,每次会话最长三十分钟。空闲超过五分钟的会话将自动释放。
其定价体现了高速服务的溢价属性。UltraSpeed 的费用是标准 MiMo-V2.5-Pro 的三倍,但生成速度约为后者的十倍。作为参考,标准 MiMo-V2.5-Pro 的价格已经远低于 Claude Opus:每百万输入 token 约 0.43 美元、每百万输出 token 约 0.87 美元,而 Opus 的对应价格分别为 5 美元和 25 美元。即使价格提高到三倍,小米的加速服务仍远比许多竞争对手的前沿模型便宜。
对于希望直接测试这项技术的开发者,小米已在 Hugging Face 上以开源形式发布底层的 MiMo-V2.5-Pro-FP4-DFlash 检查点。TileRT 也在 GitHub 上发布了部分模块。此举邀请全球研究社区验证基准数据、试验模型架构,并尝试将这些技术应用于其他模型。独立第三方验证尚未广泛公布,因此,未来几周社区通过这些开源发布开展的测试将成为真正的检验。
小米悄然崛起为 AI 强企
对大多数消费者而言,小米仍是销售平价电子产品的品牌。公司已在全球市场售出数百万部智能手机、电动滑板车和空气净化器。这种面向消费者的品牌形象掩盖了其不断壮大的人工智能部门,而直到现在,行业内大多数人都没有注意到这一点。
MiMo-V2.5-Pro 于 4 月发布时,已在大多数编程基准测试中达到 Claude Opus 的水平。UltraSpeed 并非推出了新模型,也不是一个能力缩水的版本。它加速的是同一款前沿级智能模型,而该模型此前已跻身顶尖行列。这个手机品牌实际上打造出媲美专业实验室的 AI 能力,同时价格低了整整一个数量级。
如果速度声明经得住独立审查,小米便无需像 Cerebras 和 Groq 那样投入数亿美元开发定制芯片,就实现了一项非凡成就。它将证明,在通用硬件上进行软件优化也能带来类别领先的性能。这一结果将重新塑造人们对 AI 能力来源以及哪些企业能够参与前沿竞争的认识。一家来自北京的消费电子巨头刚刚跻身顶级 AI 基础设施创新者之列,而它带来的不是定制芯片,而是标准 GPU。
要点速览
- 小米 MiMo-V2.5-Pro-UltraSpeed 在一个万亿参数模型上每秒生成超过 1,000 个 token,仅使用八块标准通用 GPU,无需定制芯片。
- 其速度约为 GPT-5.5 和 Claude Opus 的 15 倍,通过 FP4 量化、DFlash 推测解码和 TileRT 推理引擎实现。
- 限时 API 试用时间为 2026 年 6 月 9 日至 6 月 23 日,定价为标准 MiMo 的三倍,生成速度约为其十倍,企业用户和专业开发者将优先获得使用资格。
- 小米已在 Hugging Face 上以开源形式发布 FP4-DFlash 检查点,供社区验证并调整相关技术。
- 如果经独立验证,这项突破将表明,在标准云硬件上进行软件优化能够超越专用 AI 硬件公司的昂贵定制芯片方案。