游戏操控的新愿景
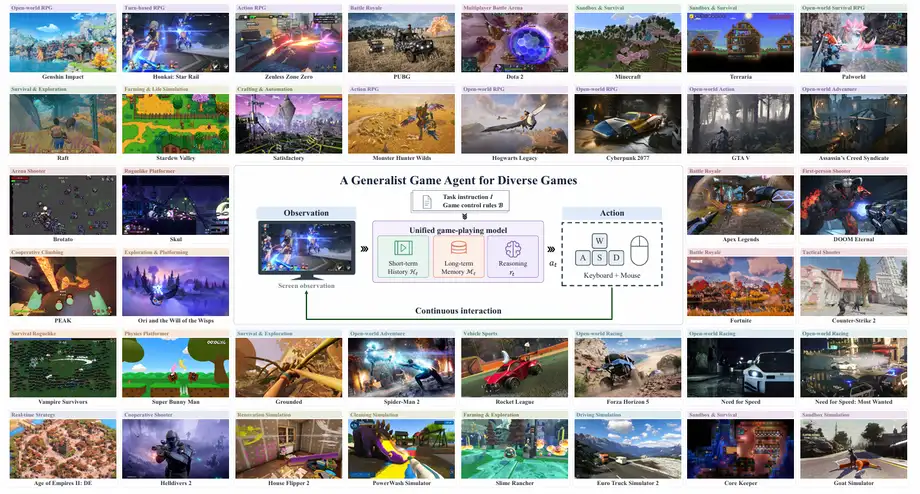
miHoYo的研究人员通过崩坏AI研发团队,并与多所学术机构合作,推出了一款名为Gamer的视觉-语言-动作基础模型。该项目摆脱了依赖游戏内部应用程序接口或修改内存状态的传统系统。相反,该框架直接处理游戏画面的原始视觉输入,并将这些观察结果直接转化为标准的键盘和鼠标指令。开发团队在预印本Gamer: A Generalist Vision-Language-Action Foundation Model for Long-Horizon Real-Time Game Agent中详细介绍了底层架构,该论文发布于arXiv,投稿历史始于2026年11月13日,最终修订于2026年11月18日。参与的研究机构包括新加坡国立大学、清华大学、中国科学技术大学、中国科学技术大学以及西安交通大学。项目团队中的知名人物包括崩坏系列多款重磅作品的制作人David Jiang,以及崩坏系列人工智能非玩家角色与玩法技术团队负责人郑银河。
与需要特权访问游戏代码的传统软件智能体不同,Gamer与数字环境的交互方式与人类玩家极为相似。该模型以五赫兹的频率捕捉屏幕帧,并利用这些视觉信号,结合任务指令和观察历史来决定合适的动作。这些决策体现为一系列以三十赫兹控制节奏执行的底层键盘状态和鼠标移动。通过将用户交互视为跨越传统图形界面和复杂三维模拟世界的通用格式,该框架为数字导航与执行提供了统一的方法。
训练流程与多阶段学习
要构建一个能够持续进行长时程游戏的自主智能体,仅靠标准的多模态指令微调是不够的。研究团队实施了一套分为三个不同阶段的完整训练流程。初始阶段是在一个由数万小时设备级键鼠交互轨迹组成的大规模数据集上进行持续预训练。这些交互记录涵盖模拟游戏和具身环境,使模型能够在多样的数字场景中学习环境动态和视觉-运动关联。根据项目文档,训练数据包含了来自VPT、D2E、OpenP2P等来源的交互轨迹,以及《崩坏:星穹铁道》的录制画面。
在持续预训练之后,模型进入稀疏推理指令微调阶段。在此阶段,框架学习如何平衡即时运动执行与审慎规划。模型不会为每一帧生成连续的解释性文本,而是直接执行常规动作,仅在关键决策点(如解谜序列或剧情选择)保留显式的推理模块。最后的训练阶段引入了一种名为时间感知群组相对策略优化(Temporal-Aware Group Relative Policy Optimization)的在线强化学习方法。该技术通过以持久记忆摘要串联轨迹片段,应对有限上下文窗口、长任务序列中累积的展开误差以及稀疏奖励等挑战。
内存管理与长时程执行
跨越数小时游戏流程的任务执行,在记忆保持和上下文限制方面带来了重大难题。当智能体探索广阔的虚拟世界时,早期交互会迅速从活跃上下文窗口中淡出,导致导航错误或目标遗忘。为了在不让无限增长的对话历史压垮系统的前提下保留任务进度,研究人员引入了一种持久记忆机制。随着任务推进、较旧的交互滚出活跃上下文,模型会生成紧凑的摘要,记录已完成的里程碑、失败的尝试、重要地点以及后续计划。
这种多阶段训练与内存管理方法的有效性通过特定角色扮演场景中的严格测试进行了评估。在《崩坏:星穹铁道》被评估的支线任务中,里程碑完成率在各训练阶段均显示出稳步提升。对于名为「机会造就窃贼(其一)」的支线任务,里程碑完成率从持续预训练后的34.4%上升到监督微调后的72.2%,在应用在线强化学习后达到80.0%。类似地,对于支线任务「兽性狂暴」,完成率从47.9%提升到69.9%,最终在强化学习优化后达到83.6%。在一组共四十项陌生小游戏任务的评估中,被标记为Gamer-RL的版本平均成功率达到49.7%。
实时推理与流式架构
要在实时交互中保持高性能,必须将推理延迟严格控制在交互式软件的容忍阈值之内。为防止延迟导致智能体错过快节奏环境中的动态事件,开发团队设计了一套名为Streaming-vLLM的云边协同服务系统。该推理引擎结合了持久上下文复用、经过验证的投机解码和早期动作分发,以高效处理并行展开。持久上下文复用通过在帧之间保留键值缓存,避免对历史屏幕状态的重复计算;早期动作分发则在后续令牌生成完成之前,将第一组有效的键盘指令发送给游戏客户端。
项目仓库中详述的性能基准测试展示了这些优化的效果。在配备NVIDIA H200硬件的环境中,采用基于Qwen3.5-35B-A3B、张量并行度设为四的模型配置,基线设置的端到端请求延迟为1,306.00毫秒。在应用Streaming-vLLM优化之后,该请求延迟降至65.12毫秒。执行时间的缩短使系统能够支持并发的在线评估,并在复杂的空间导航和战斗序列中保持响应迅速的控制循环。
研究范围与实际边界
该研究框架的发布引发了关于其潜在能力和预期用途的广泛讨论。项目文档和研究团队的公开声明强调,Gamer是一个学术探索项目,旨在研究交互环境中通用智能体的行为,而非用于自动化玩家账号或获取竞争优势的授权商业工具。出于数据安全考虑,团队扣留了与专有游戏相关的具体训练数据和模型权重,仅通过Gamer GitHub仓库等资源公开基础预训练文件和系统文档。
开发者勾勒的潜在实际应用主要聚焦于产业和研发用途,而非面向消费者的自动化。自动化测试流程可以利用此类模型,在分支叙事路径和广阔虚拟世界中开展压力测试,比传统人工验证方法更快地发现实现缺陷。此外,其底层原理也为无障碍辅助和人机交互研究提供了启示,为能够将多种输入模态转化为精确数字动作的智能体铺平了道路。
要点速览
- 该研究框架由miHoYo的崩坏AI研发团队与包括新加坡国立大学、清华大学在内的学术机构合作开发。
- 详细的研究发现和架构说明记录于预印本Gamer: A Generalist Vision-Language-Action Foundation Model for Long-Horizon Real-Time Game Agent中。
- 该系统以五赫兹的频率捕捉原始屏幕观察,并输出原生键鼠指令,无需内部应用程序接口或内存钩子。
- 训练流程包括在数万小时交互轨迹上进行持续预训练、稀疏推理指令微调以及时间感知群组相对策略优化。
- 定制推理引擎Streaming-vLLM在使用NVIDIA H200硬件的测试中,将请求延迟从1,306.00毫秒降低到65.12毫秒。
- 研究团队坚称,该项目是一项学术研究,面向自动化测试和无障碍研究等应用,而非用于游戏玩法自动化的商业工具。